Slitherlink
Slitherlink
Slitherlink oder Suriza (japanisch スリザーリンク - surizā rinku) ist ein japanisches Puzzle. Es wurde erstmals 1989 vom Sudoku-Herausgeber Nikoli veröffentlicht. Es ist ein nachgewiesen NP-vollständiges Problem[1].
Spielregeln
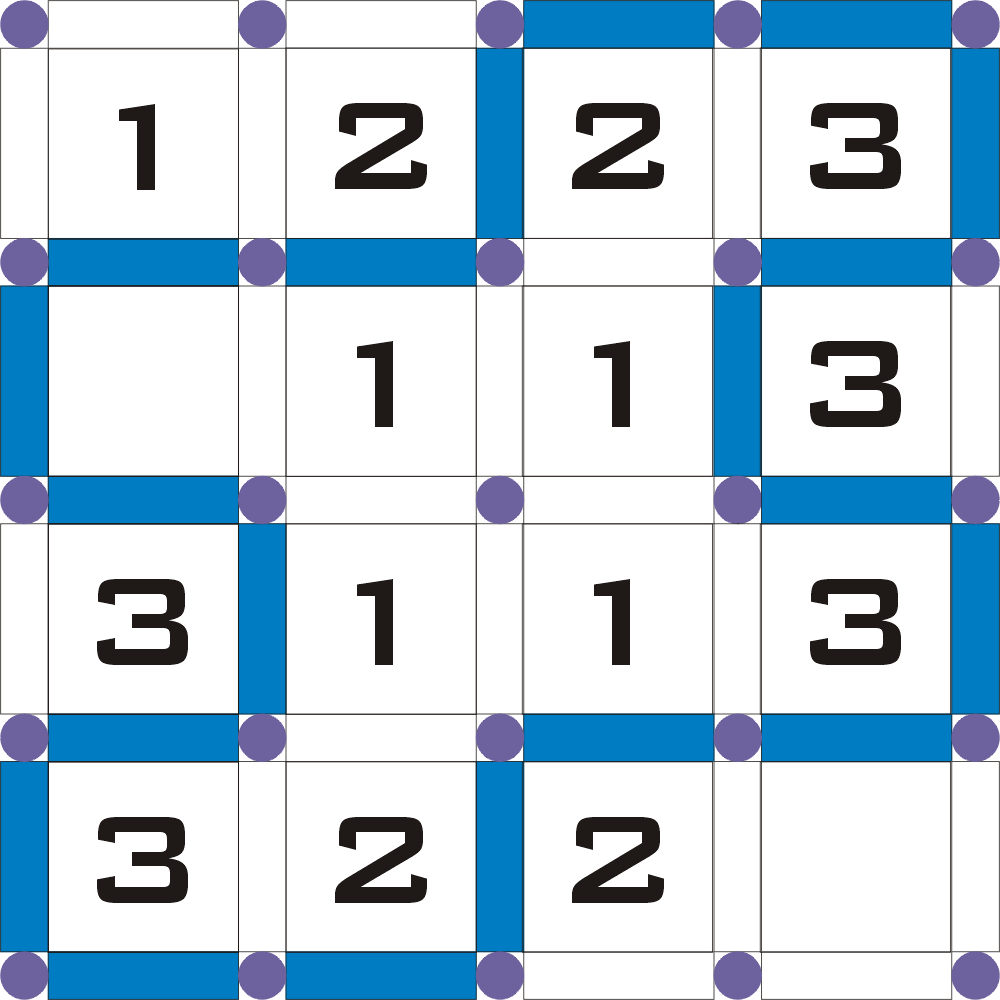
Das Spielfeld ist ein m x n Gittergraph. In den Zellen können Zahlen von 0 bis 3 stehen. Das Ziel ist es, benachbarte Knoten so zu verbinden, dass ein Zyklus entsteht. Dabei gilt es, die folgenden drei Regeln zu beachten:[2]
- Verbinde benachbarte Knoten mit horizontalen oder vertikalen Kanten, sodass genau ein Zyklus entsteht.
- Die Zahlen geben an, wie viele Linien eine Zelle umgeben müssen. Leere Zellen können durch beliebig viele Linien umgeben werden.
- Der Zyklus kreuzt sich nicht selbst nicht und es gibt keine Verzweigungen.
Gute Slitherlink-Puzzles haben eine eindeutige Lösung. In Abbildung 1[3] ist ein kleines Slitherlink-Puzzle dargestellt.
Spielvarianten
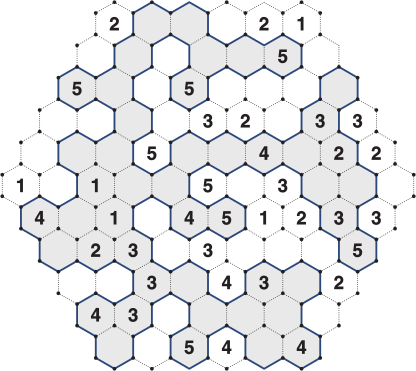
Hexagonal Slitherlink[4]
Es wird nach den selben Regeln gespielt, aber das Spielfeld besteht aus Hexagonen. Die Zahlen in den Zellen können entsprechend größer sein. In dem Beispiel aus Abbildung 2[4:1] gibt es auch Zellen mit der Nummer 4 oder 5.
No-Square Slitherlink[5]
Es gilt neben den Standardregeln noch die Zusatzregeln, dass es keinen 2x2 Bereich an Zellen innerhalb des Zyklus geben darf. Lösungen die zuvor bei Slitherlink möglich waren, können dadurch wie in Abbildung 3[5:1] verboten werden.
Colorlink[6]
Die Slitherlink-Regeln werden um die Folgenden ergänzt:
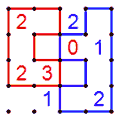
- Die Zahlen haben unterschiedliche Farben, z.B. rot und blau wie in Abbildung 4[6:1]. Es soll für jede Farbe außer schwarz ein Zyklus nach Slitherlink-Regeln gefunden werden.
- Zahlen anderer Farben haben keinen Einfluss auf Zyklen anderer Farben.
- Zyklen unterschiedlicher Farben dürfen sich kreuzen.
- Linien dürfen jeweils von nur einer Farbe belegt werden.
- Schwarze Zahlen geben die Anzahl der umgebenden Linien unabhängig von der Farbe an.
Lösungsstrategien
Für gewöhnlich geht man so vor, dass man damit beginnt kleinere eindeutige Teillösungen zu bestimmen, um diese dann zu einem geschlossenen Kreis zu verbinden[7]. Zudem ist es sinnvoll, Linien auszustreichen, die nicht Teil der Lösung sein können. In Abbildung 5[2:1] ist die Progression beim Lösen von Slitherlink exemplarisch dargestellt.
Ausgewählte Linien stimmen mit Zellennummer überein
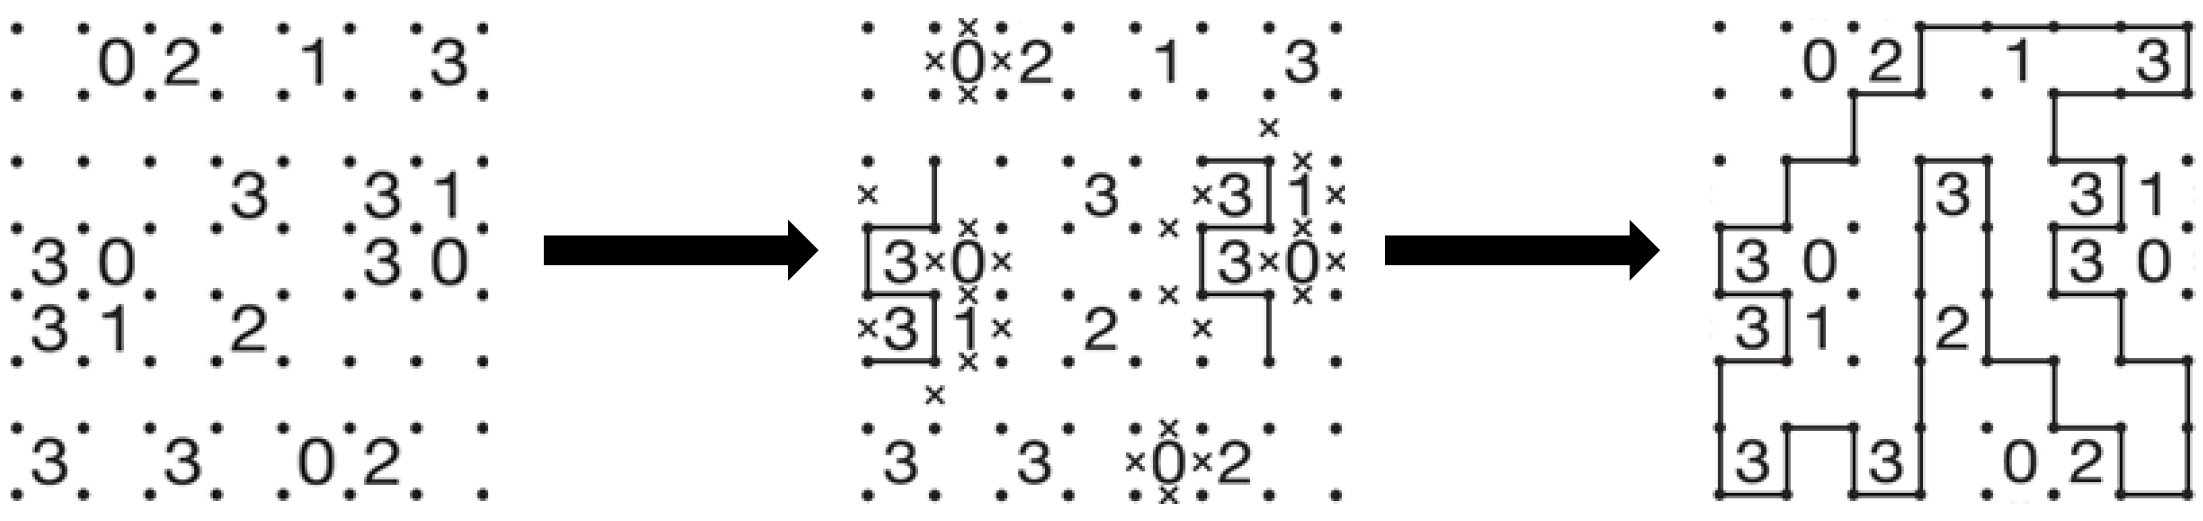
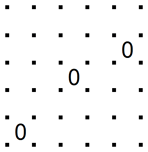
Für den Fall, dass die Anzahl ausgewählter Linien mit der Nummer einer Zelle übereinstimmt, können alle anliegenden und noch nicht gewählten Kanten ausgeschlossen werden. Dies ist bei Zellen mit der Nummer 0 wie in Abbildung 6[8] leicht zu erkennen.
0 oder 2 angrenzende Linien an jedem Knotenpunkt
Die Erkenntnis, dass jeder Knoten nur 0 oder 2 angrenzende Linien hat, führt zu vielen verschiedenen Deduktionsstrategien, wie z.B. die Folgenden.
Zellen mit 3:
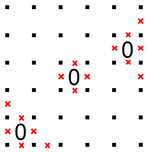
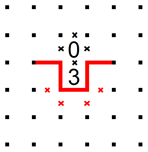
- 3 mit benachbarter 0: In diesem Fall können alle Linien um die 3 gewählt werden außer die an der 0 angrenzende. Außerdem kann die Teillösung um die 2 orthogonale Linien in beide Richtungen verlängert werden, denn an der 0 darf keine weitere Linie angrenzen und die beiden Enden dürfen nicht offen sein. In der Abbildung 7[8:1] können drei Linien links, rechts und unten von der 3 gezogen werden und die Lösung kann um je eine Linie nach rechts und links erweitert werden. Zudem können für Knotenpunkte, die bereits 2 anliegende Linien haben, die anderen möglichen Linien ausgeschlossen werden.
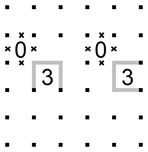
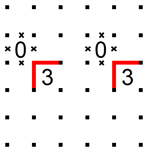
- 3 mit diagonaler 0: Bei dieser Anordnung, müssen beide Linien, die an der Ecke zur 0 angrenzen, gewählt werden. Andernfalls wäre eines der beiden Enden der Teillösung an dem zu 0 angrenzenden Knotenpunkt und der Weg könnte nicht weitergeführt werden. Die grauen Linien in Abbildung 8[8:2] zeigen die einzigen beiden Möglichkeiten, die Linien um die 3 zu ziehen.
- Zwei benachbarte 3en: Die Linie zwischen beiden Zellen muss ausgewählt werden. Andernfalls würde ein geschlossener Zyklus entstehen, der nicht mit weiteren Teilstücken verbunden werden kann. Außerdem können die dazu parellelen Linien ausgewählt werden. In Abbildung 9[8:3] werden mit den grauen Linien die beiden Möglichkeiten, die Linien um diese Zellen herumzuziehen, dargestellt. Zudem wissen wir, dass die mittlere rot markierte Linie nicht gerade weitergeführt werden kann, da drei Seiten der Zelle abgedeckt werden müssen.
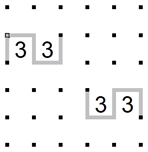
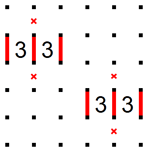
Diese Regel gilt nicht für triviale Slitherlink-Puzzles, welche durch einen einfachen Zyklus um zwei benachbarte 3-Zellen gelöst werden können, weil es keine anderen Zahlen gibt.[9]
Zellen mit 1:
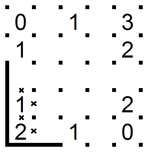
- Teillösung führt zur 1: Wenn die Linie an einer Zelle mit der Nummer 1 endet, muss man möglicherweise die Lösung um die 1 herum weiterführen. Dies könnte zum Beispiel aufgrund des Spielfeldrands in Abbildung 10 erforderlich sein. In solchen Fällen können wir die Linien, die nicht direkt am bestehenden Pfad liegen, ausschließen.
Spielfeldecken:
- 1 in einer Ecke: Die Linien zu den äußersten Eckpunkten können ausgeschlossen werden. Würde eine dieser Linien ausgewählt werden , könnte der Weg vom Eckpunkt aus nicht mehr weitergeführt werden, da bereits eine Linie an der Zelle anliegt.
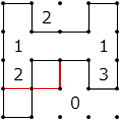
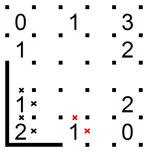
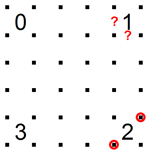
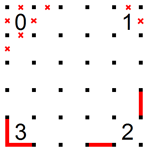
- 2 in einer Ecke: Es müssen zwei Linien von der Ecke weg führen an der Spielfeldgrenze. Es gibt zwei mögliche Wege, die jeweils die in der Abbildung 11[8:4] rot umkreisten Knoten verbinden. Um den Weg sinnvoll weiterzuführen sind diese beiden Linien an der Grenze notwendig.
- 3 in einer Ecke: In diesem Fall können die beiden äußeren Linien an der Spielfeldgrenze ausgewählt werden. Eine Auswahl von 3 Linien für diese Eckzelle ohne beide dieser Linien führt zu mindestens einem offenen Endpunkt, an dem nur eine Linie anliegt und keine weitere gewählt werden kann.
Lösungsansatz mithilfe von ZDDs
Basierend auf dem SIMPATH-Algorithmus zur Repräsentation von s-t Pfaden als ZDD haben Yoshinaka et. al.[10] einen Solver für Instanzen von Slitherlink entworfen. Es soll ein ZDD generiert werden, welches alle Lösungen für eine gegebene Slitherlinkinstanz darstellt. Mit anderen Worten sollen alle Zellen entsprechend ihrer Zahl abgedeckt sein.
Definition Slitherlinkinstanz
Eine Instanz für Slitherlink ist ein Tupel aus einem Eingabegraphen
Pseudocode (angepasst)
initialize mate;
initialize count;
create root labeled with first edge;
create 0-terminal, 1-terminal;
Q = new Queue;
Q.enqueue(root);
while Q not empty
		node = Q.enqueue;
    e = edge node is labeled with;
    if node has fixed end or is incompatible with h
    		create 0-arc from node to 0-terminal;
    else
    		childnode = create new node;
        create 0-arc from node to childnode;
    if taking e forms a cycle matching h
    		create 1-arc from node to 1-terminal;
		else if taking e declines state of n or is incompatible with h
    		create 1-arc from node to 0-terminal;
		else
    		childnode = create new node;
        create 0-arc from node to childnode
Arbeitsweise
Der Algorithmus iteriert ähnlich wie SIMPATH in einer Art Breitensuche über die Kanten. Auch hier müssen die Kanten zunächst in einer totalen Ordnung sein.
Es wird eine Funktion
mate(v) = v , fallsv noch nicht betrachtet wurde.mate(v) = 0 , fallsv bereits zweimal besucht wurde.mate(v) = u , falls die Kanteu-v gewählt wurde.
Neben der
Intitial ist
mate updaten:
Nach Wahl einer Kante
j^* = mate(j) m^* = mate(m) mate(j)=0 mate(m)=0 mate(j^*) = m^* mate(m^*)= j^*
Außerdem wird der Definitionsbereich von
count updaten:
Nach Wahl einer Kante
Definitionen:
Es gibt einen festen Endpunkt für eine Kante
Der Zustand eines Knoten ist inkompatibel mit
Das Auswählen einer Kante
Das Auswählen einer Kante erfüllt
Das Auswählen einer Kante
Folgezustände erkennen:
Innerhalb der while-Schleife (Z. 8-21 im Pseudocode) werden verschiedene Bedingungen geprüft, um den passenden Folgeknoten im ZDD für den 0-arc bzw. 1-arc zu finden.
Fall 1: Die aktuelle Kante soll nicht ausgewählt werden (0-arc).
- Falls es einen festen Endpunkt oder einen inkompatiblen Zustand mit
h gibt, kann die Kante nicht ausgewählt werden, d.h. es gibt ein 0-arc zu 0-terminal. - Sonst wird ein neuer Knoten im ZDD generiert, der über ein 0-arc verbunden wird.
Fall 2: Die aktuelle Kante soll ausgewählt werden (1-arc).
- Falls das Auswählen der Kante einen Kreis, der
h erfüllt, erzeugt, wurde eine Lösung gefunden, d.h. 1-arc zu 1-terminal. - Falls das Auswählen zu einem festen Endpunkt führt, es abgelehnt wird oder es zu einem mit
h inkompatiblen Zustand führt, kann die Kante nicht ausgewählt werden, d.h. 1-arc zu 0-terminal. - Sonst wird ein neuer Knoten im ZDD generiert, der über ein 1-arc verbunden wird.
Beispiele:
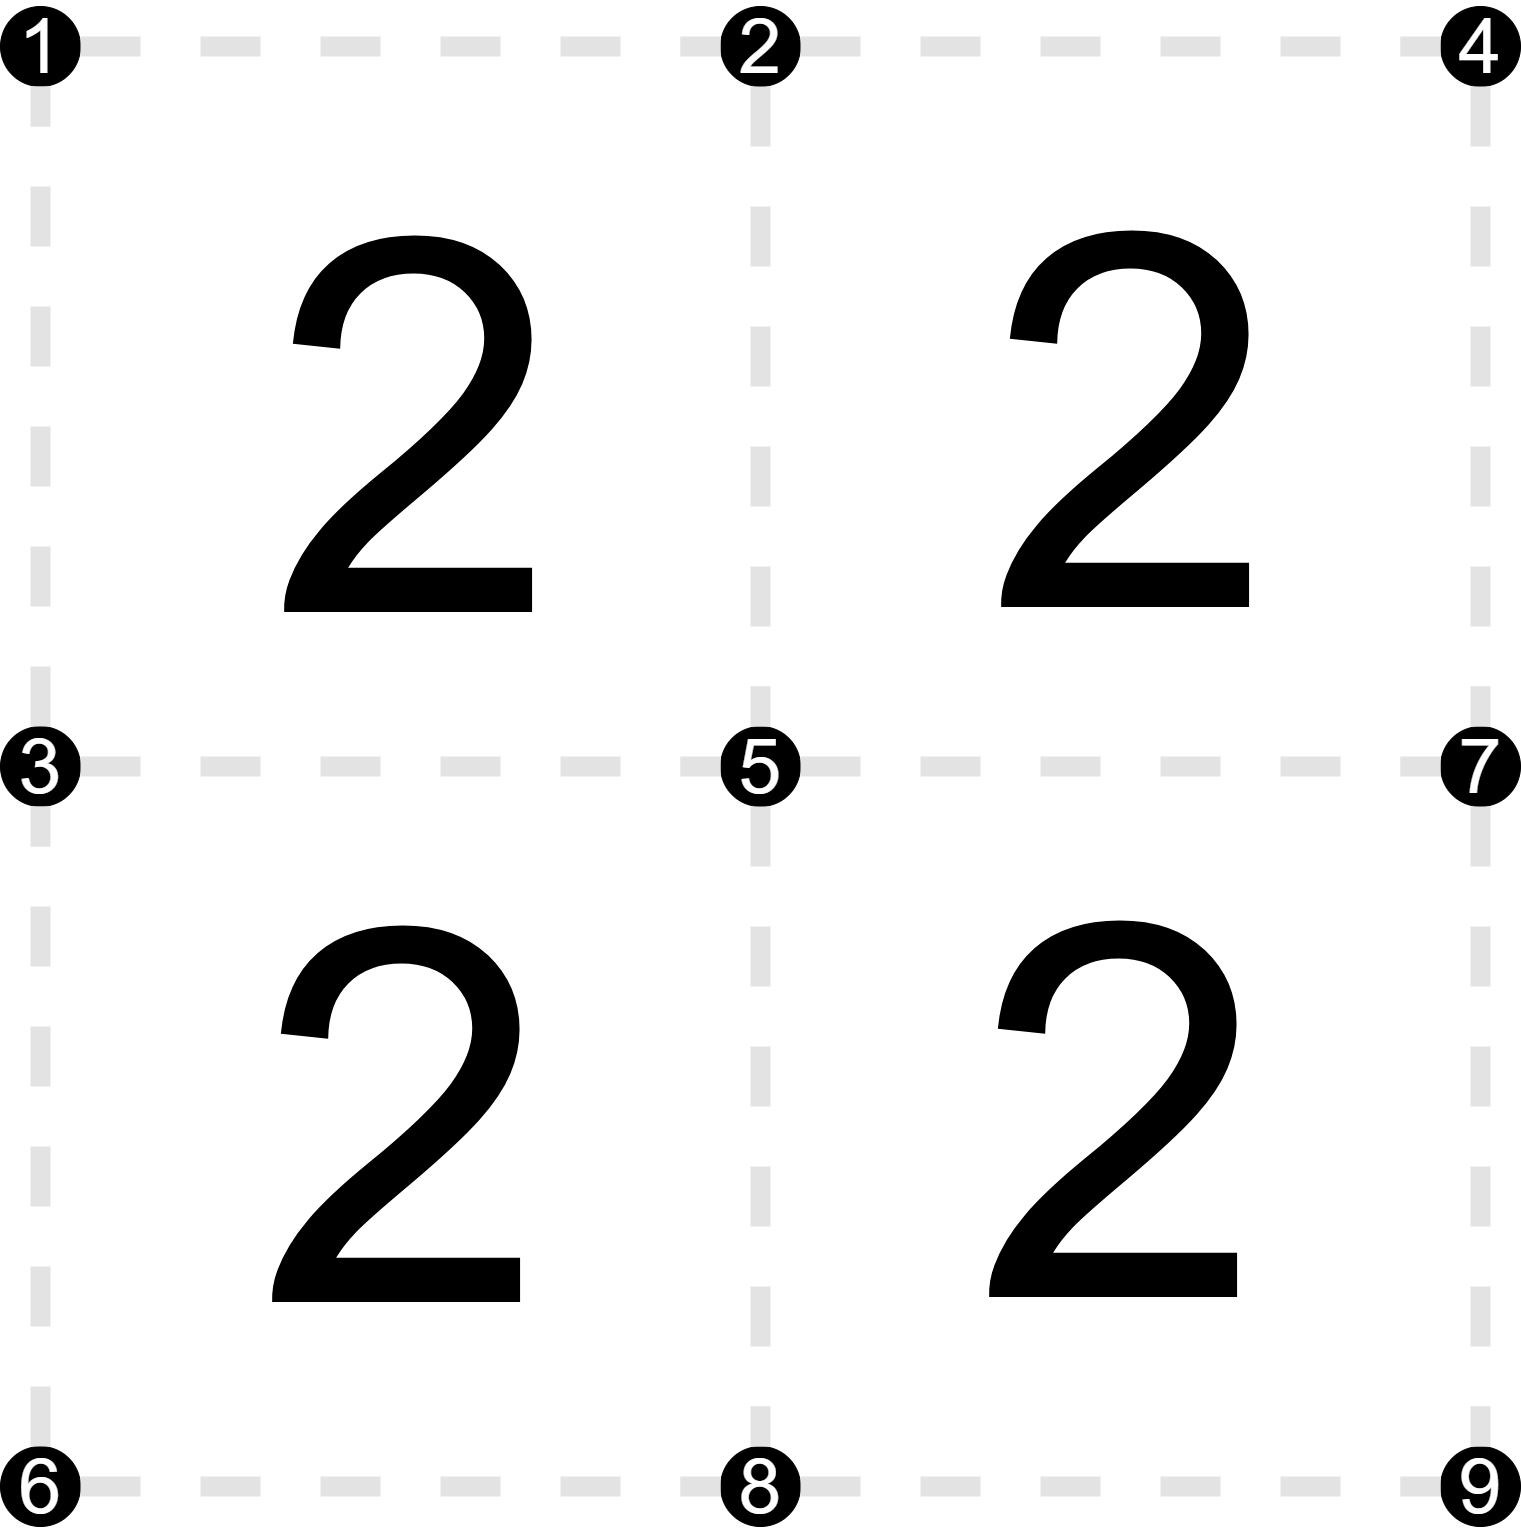
Das einfache Beispiel in Abbildung 12 wird betrachtet und verschiedene Zustände, die bei der Anwendung des Algorithmus auftreten werden, werden untersucht. Die Kantenordnung wird entsprechend der angegebenen Knotennummerierung betrachtet, z.B.
h(E_1=\{1-2,1-3,2-5,3-5\}) = 2 h(E_2=\{2-4,2-5,4-7,5-7\}) = 2 h(E_3=\{3-5,3-6,5-8,6-8\}) = 2 h(E_4=\{5-7,5-8,7-9,8-9\}) = 2
- Aktuelle Kante
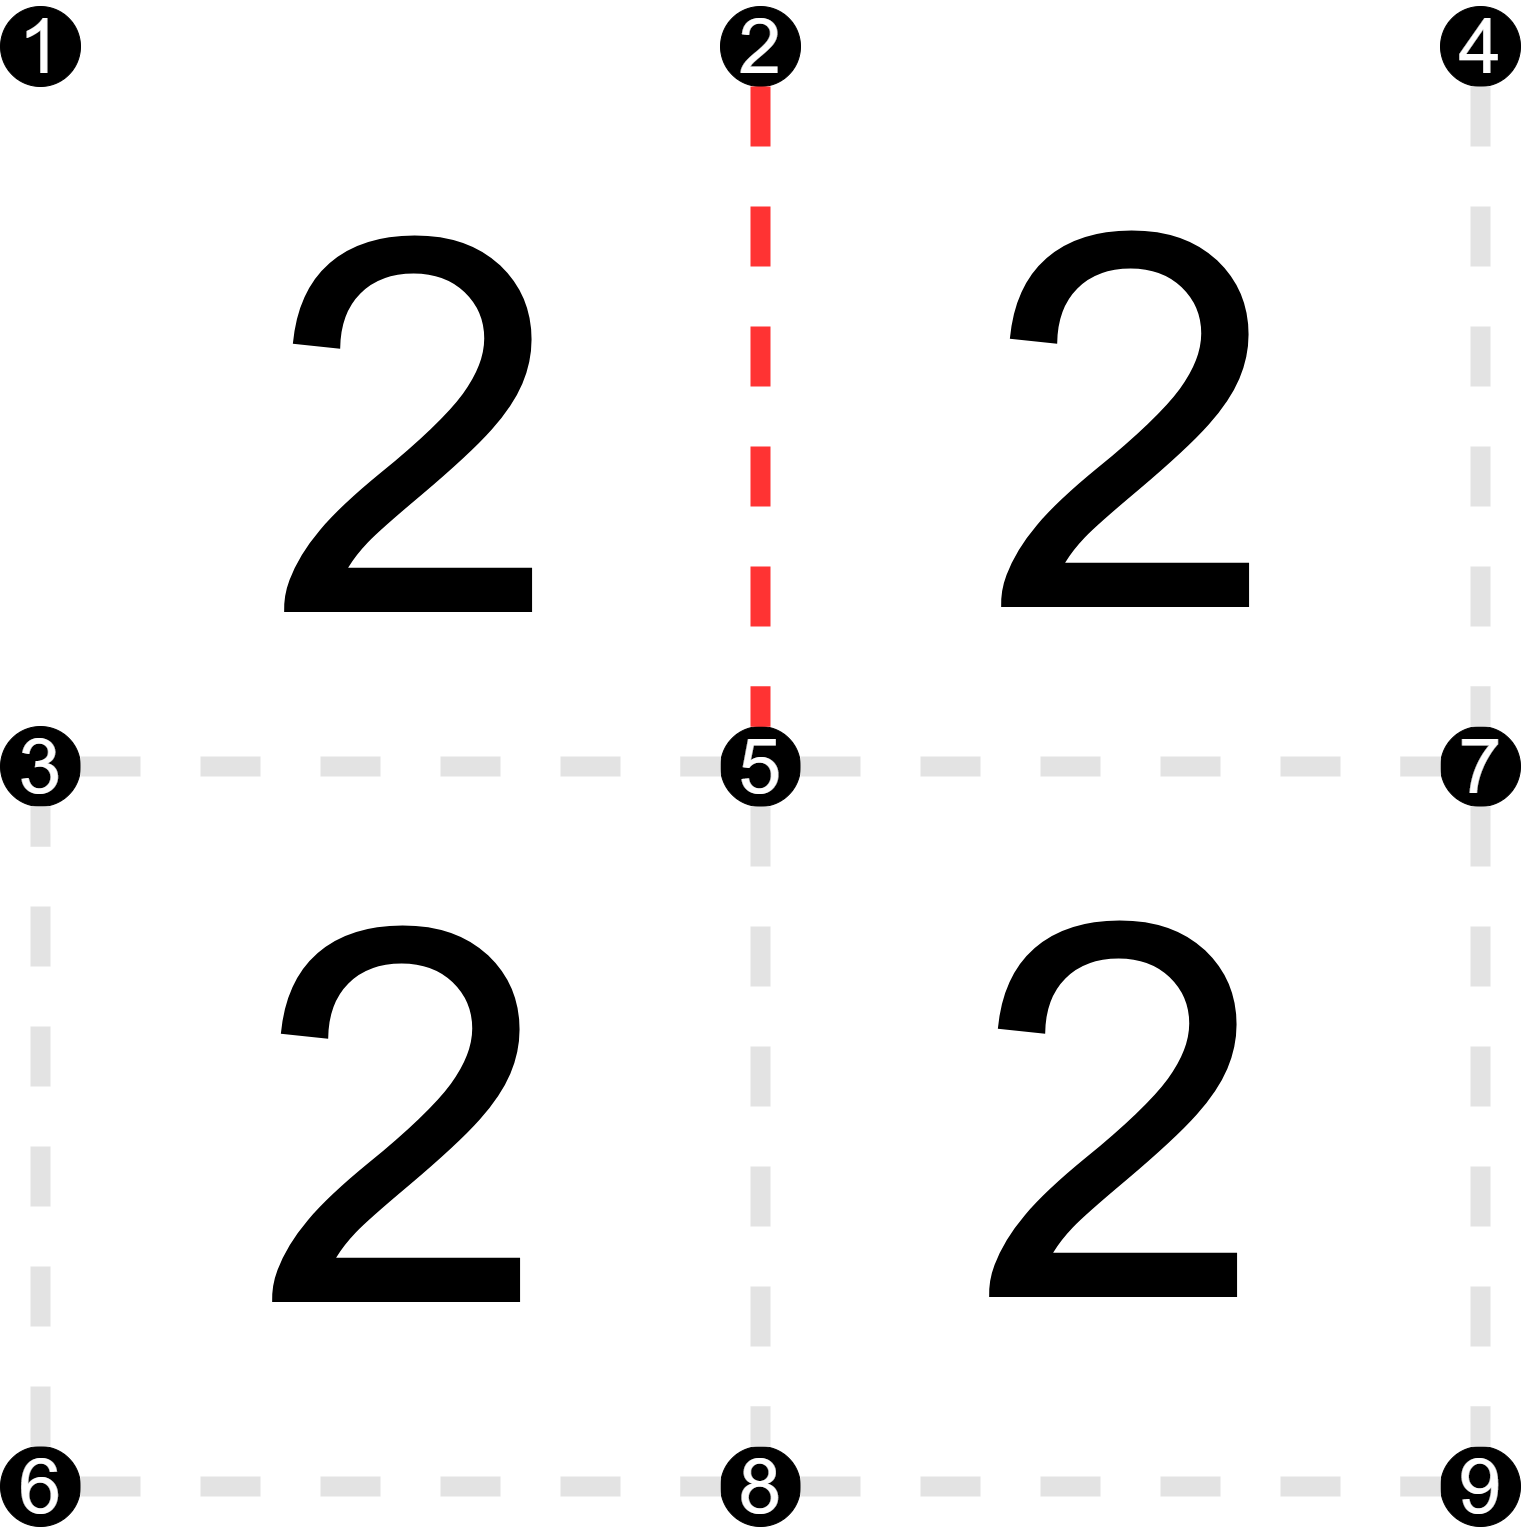
2-5 , nachdem1-2 ,1-3 und2-4 nicht gewählt wurden (Abbildung 13).
| j | m | ||||
|---|---|---|---|---|---|
| 2 | 5 | 1 2 3 4 5 6 7 8 9 | 1 5 3 4 2 6 7 8 9 | 0 0 0 0 | 1 1 0 0 |
Der Zustand des Knoten ist inkompatibel mit
Allerdings führt das Auswählen von
- Aktuelle Kante
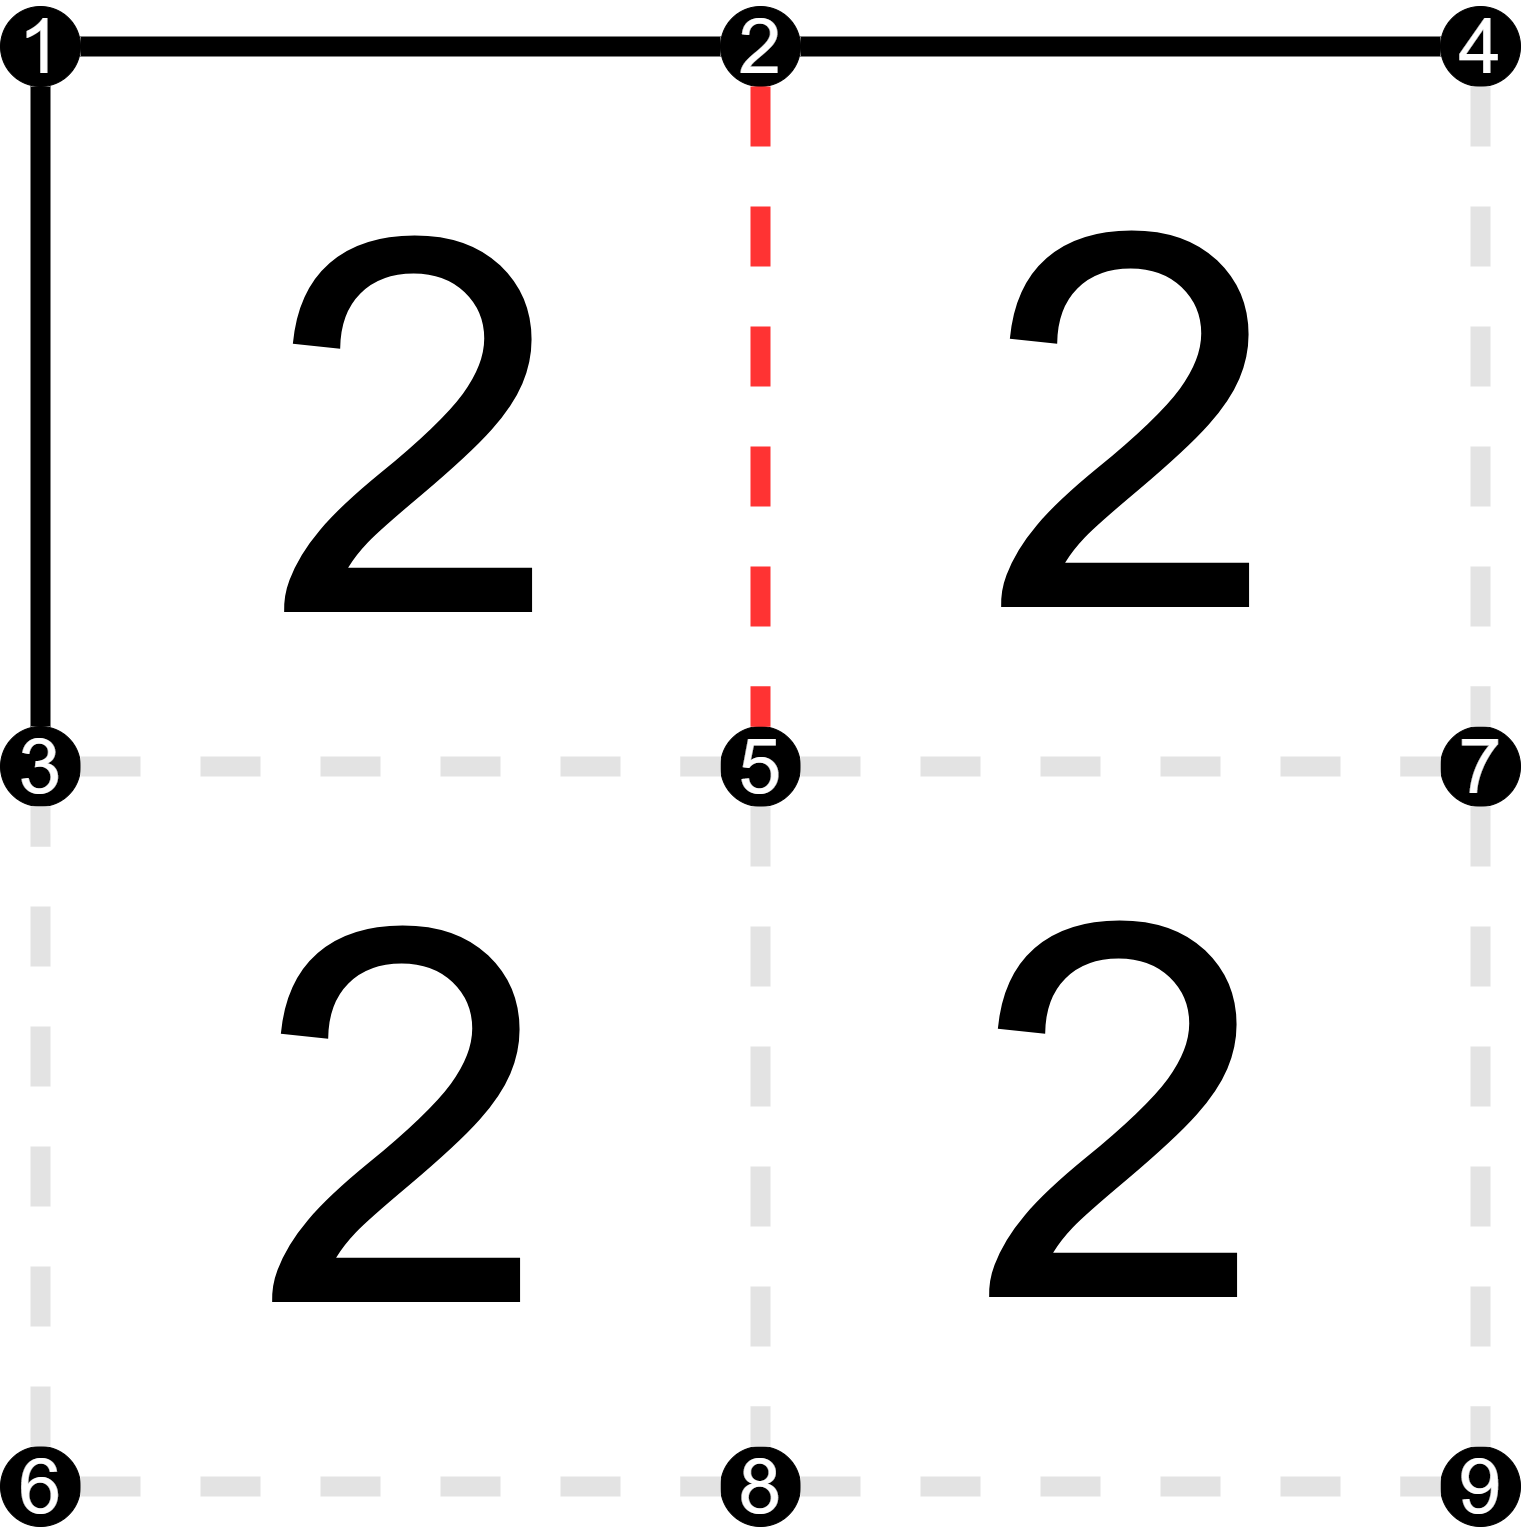
2-5 , nachdem1-2 ,1-3 und2-4 gewählt wurden (Abbildung 14).
| j | m | ||||
|---|---|---|---|---|---|
| 2 | 5 | 0 0 4 3 5 6 7 8 9 | - | 2 1 0 0 | - |
Das Auswählen von
- Aktuelle Kante
8-9 , nachdem1-2 ,1-3 ,2-4 ,3-6 ,4-7 ,6-8 und7-9 gewählt wurden (Abbildung 15).
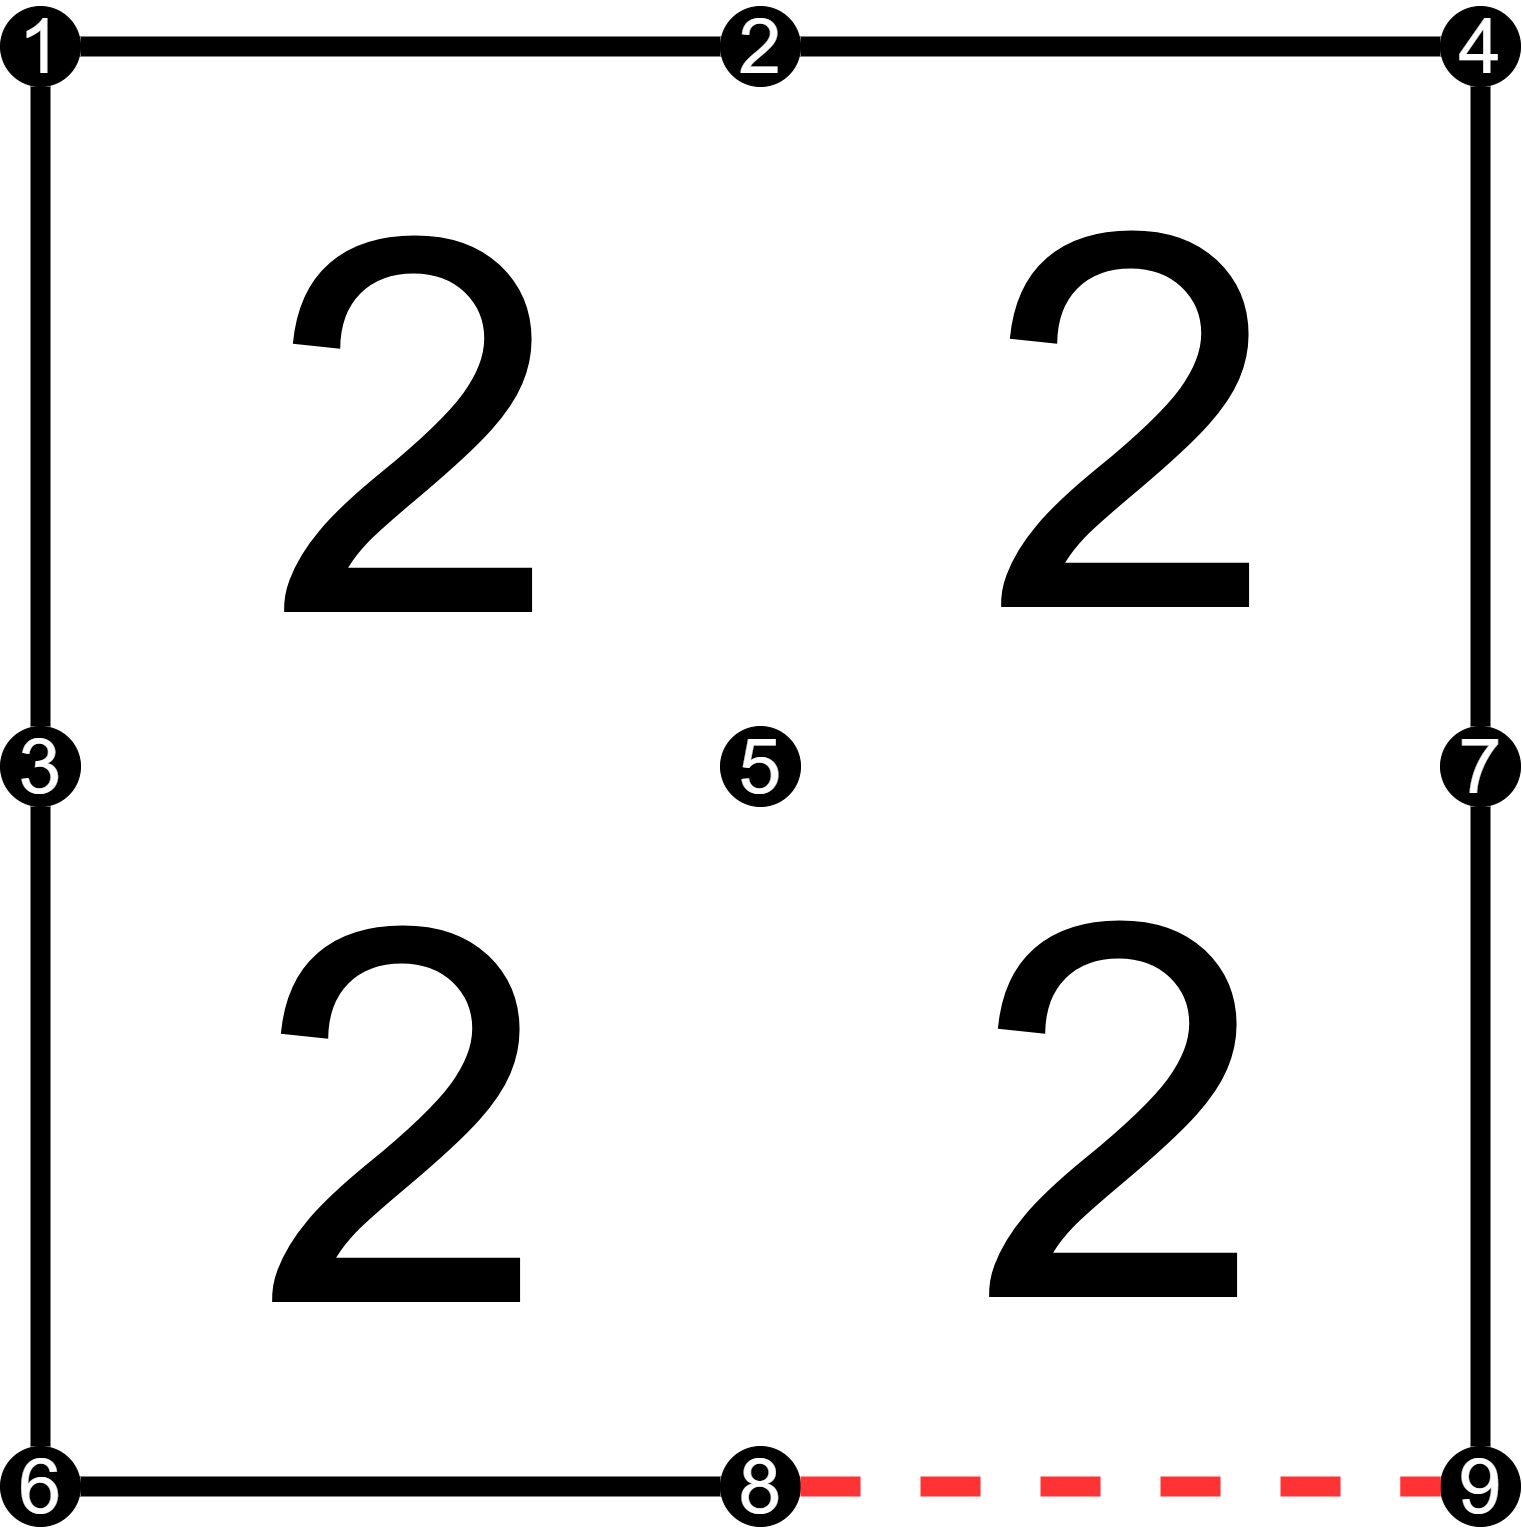
| j | m | ||||
|---|---|---|---|---|---|
| 8 | 9 | 0 0 0 0 5 0 0 9 8 | - | 2 2 2 1 | 2 2 2 2 |
Die Wahl von
Bei einen guten Slitherlink-Puzzle mit nur einer Lösung, kann der Algorithmus bei dem ersten
h -erfüllenden gefundenen Kreis abgebrochen werden.
Vergleich mit anderen Solvern
Die Autoren haben ihren Algorithmus für verschiedene Instanzen mit dem SAT-Solver Sugar und dem Integer Programming Solver CPLEX verglichen. Im Ergebnis schlägt der ZDD-Algorithmus für viele Instanzen Sugar. Es gibt auch Beispiele, bei denen Sugar zeiteffizienter war. CPLEX ist in manchen Fällen schneller. Die Instanzen wurden auch mit einem heuristische Solver slink getestet. Dieser war für alle Instanzen deutlich schneller. Laut den Autoren seien diese Ergebnisse damit zu erklären, dass Sugar und CPLEX eher für allgemeinere Zwecke entwickelt wurden, während slink speziell für Slitherlink designt wurde und die ZDD-Lösung eher dazwischen liegt.
| Instance | Graph size | Time Sugar | Time CPLEX | Time ZDD-Algo | Time slink |
|---|---|---|---|---|---|
| BS1 | 11x11 | 5,460 | 0,07 | 0,116 | 0,001 |
| BS12 | 11x11 | 4,696 | 0,28 | 0,384 | 0,004 |
| BS25 | 11x11 | 6,496 | 0,12 | 0,060 | 0,001 |
| BS37 | 11x11 | 8,773 | 0,14 | 0,044 | 0,004 |
| BS43 | 19x11 | 8,349 | 0,17 | 0,060 | 0,001 |
| BS54 | 19x11 | 7,380 | 0,40 | 0,304 | 0,008 |
| BS68 | 25x15 | 12,433 | 0,39 | 0,384 | 0,004 |
| BS77 | 25x15 | 13,281 | 0,90 | 0,376 | 0,004 |
| BS89 | 37x21 | 48,035 | 1,56 | 9,329 | 0,016 |
| BS96 | 37x21 | 186,612 | 3,07 | 26,286 | 0,104 |
| S10 | 37x21 | 1411,944 | 41,43 | 4569,330 | 0,036 |
| C95 | 32x46 | 1076,839 | 95,93 | - | 0,088 |
Laufzeit angegeben in Sekunden für das Lösen von Slitherlink. Für C95 konnte der ZDD-Solver keine Lösung finden aufgrund nicht ausreichenden Speichers.
Lösungsansatz mit SMT-Solver
Eine Lösungsmöglichkeit ist der Constrained-Based Ansatz dabei generiert man aus einem gegebenen Spielfeld eine aussagenlogische Formel und sucht eine Lösung mithilfe von bekannten SAT oder SMT Solvern. Miyauchi und Tanaka[11] haben eine SMT-Lösung entwickelt, die für einige Fälle bessere Ergebnisse als vorherige Slitherlink-Solver erreichen konnte.
Referenzen
T. Yato und T. Seta, "Complexity and completeness of finding another solution and its application to puzzles," IEICE transactions on fundamentals of electronics, communications and computer sciences, Jg. 86, Nr. 5, S. 1052–1060, 2003. pdf ↩︎
Nikoli. "Slitherlink.” https://www.nikoli.co.jp/en/puzzles/slitherlink/ ↩︎ ↩︎
Wikipedia. "Suriza." https://de.wikipedia.org/wiki/Suriza ↩︎
puzzlephil. "Slitherlink-Specials." https://puzzlephil.com/puzzles/slitherlinkspecials/de/ ↩︎ ↩︎
janko. "No-Square Slitherlink." https://www.janko.at/Raetsel/Varianten/017.a.htm ↩︎ ↩︎
janko. "Colorlink." https://www.janko.at/Raetsel/Varianten/019.a.htm ↩︎ ↩︎
Wikipedia. "Slitherlink." https://en.wikipedia.org/wiki/Slitherlink#Solution_methods ↩︎
Conceptis. "Slitherlink Techniken." https://www.conceptispuzzles.com/de/index.aspx?uri=puzzle/slitherlink/techniques, ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
D. Westreicher, „Slitherlink Reloaded," Bachelorarbeit, 2011. pdf ↩︎
R. Yoshinaka, T. Saitoh, J. Kawahara, K. Tsuruma, H. Iwashita und S. Minato, "Finding All Solutions and Instances of Numberlink and Slitherlink by ZDDs," Algorithms, Jg. 5, Nr. 2, S. 176–213, 2012, doi: 10.3390/a5020176. pdf ↩︎
T. Miyauchi und K. Tanaka, "Solving Slitherlink with FPGA and SMT Solver," Journal of Information Processing, Jg. 28, S. 959–969, 2020, doi: 10.2197/ipsjjip.28.959. pdf ↩︎