MiniMax-Algorithmus
Einleitung
Der MiniMax Algorithmus ist ein rekursiver, tiefenlimitierter Suchalgorithmus, der den Gewinn des MAX Spielers unter der Annahme optimiert,[1] dass auch der Gegenspieler (MIN) stets den für ihn besten Zug wählt. MiniMax wird vor allem in der Spieltheorie und in der KI gestützten Spielanalyse eingesetzt.
Grundprinzip
Die Grundlage des MiniMax Algorithmus bildet das Minimax Prinzip.
Minimax-Prinzip: Maximiere den minimal zu erwartenden Gewinn.
Der Algorithmus geht von zwei Spielern aus, MAX und MIN, die abwechselnd am Zug sind und jeweils den für sie optimalen Zug wählen.
MAX-Knoten: versucht das Ergebnis zu maximieren, Knoten wählen den Nachfolger mit dem höchsten Wert
MIN-Knoten: versucht das Ergebnis zu minimieren, mit dem niedrigsten Wert auswählen
Das Spiel wird dabei als Suchbaum modelliert: Jeder Knoten repräsentiert einen Spielzustand, jede Kante eine mögliche Aktion. Die Blattknoten stehen für Endzustände des Spiels und werden mithilfe einer Bewertungsfunktion bewertet.
Der Startknoten ist ein MAX Knoten und repräsentiert den initialen Zustand des Spiels. MAX und MIN Knoten wechseln sich im Baum ab, sodass MAX Knoten ausschließlich MIN Knoten als Kinder besitzen und umgekehrt. Durch Tiefensuche entsteht so, ein vollständiger Suchbaum bis zur vorgegebenen Tiefe. Die Bewertungen der Endzustände werden anschließend rekursiv nach oben propagiert.
Nachdem der gesamte Baum erzeugt und alle Blattknoten bewertet wurden, wird der optimale Zug bestimmt, indem die propagierten Werte bis zum Startknoten zurückgegeben werden. Dieser wählt schließlich den Kindknoten mit dem höchsten Wert aus und damit den Zug, der unter optimalem Gegenspiel den bestmöglichen Ausgang verspricht.
Algorithmus[2]
Psydocode für den MAX-Knoten:
def Max-Value(state):
    if Terminal-Test(state): return Utility(state)
    v = -INF
    for (a, s) in Successors(state):
        v = MAX(v, Min-Value(s))
    return v
Psydocode für die MIN-Knoten:
def Min-Value(state):
    if Terminal-Test(state): return Utility(state)
    v = +INF
    for (a, s) in Successors(state):
        v = MIN(v, Max-Value(s))
    return v
Psydocode für den Startknoten:
def Minimax(state):
    (val, action) = (-INF, null)
    for (a, s) in Successors(state):
        v = Min-Value(s)
        if (val <= v):
            (val, action) = (v, a)
    return action
Komplexität
Vollständigkeit Ja (Voraussetzung sind endliche Spielbäume
Optimalität Ja (beide Spieler müssen perfekt spielen)
Zeitkomplexität O (bm) [2:1]
Speicherkomplexität O (b*m) [2:2]
b = Verzweigungsgrad
m = maximale Baumtiefe
Expectimax-Algorithmus
Einleitung
Expectimax ist ein rekursiver, tiefenlimitierter Suchalgorithmus, der – ähnlich wie der Minimax Algorithmus – einen Spielbaum schrittweise aufbaut und diesen nach dem optimalen Zug durchsucht.[3] Im Gegensatz zum klassischen MiniMax kann Expectimax jedoch auch Zufallsereignisse berücksichtigen und eignet sich daher für Spiele, in denen neben gegnerischen Entscheidungen auch stochastische Einflüsse auftreten.
Grundprinzip
Der Expectimax Algorithmus ähnelt dem MiniMax Algorithmus in seiner Grundstruktur, da beide auf einem Spielbaum basieren, der mithilfe von Tiefensuche erzeugt wird. Der entscheidende Unterschied besteht jedoch darin, dass Expectimax keine MIN Knoten verwendet. Stattdessen treten Zufallsknoten auf, die Zufallsereignisse modellieren.
Zufallsknoten: Jedem Zufallsknoten wird der Erwartungswert seiner möglichen Folgezustände zugewiesen.[4]
Die Bewertung eines solchen Knotens erfolgt nach der folgenden Formel:
Expectimax(s)=∑_i P(child_i)⋅U(child_i)
P(child_i) = die Wahrscheinlichkeit, mit der der jeweilige Nachfolger eintritt
U(child_i) = Bewertung des jeweiligen Nachfolger
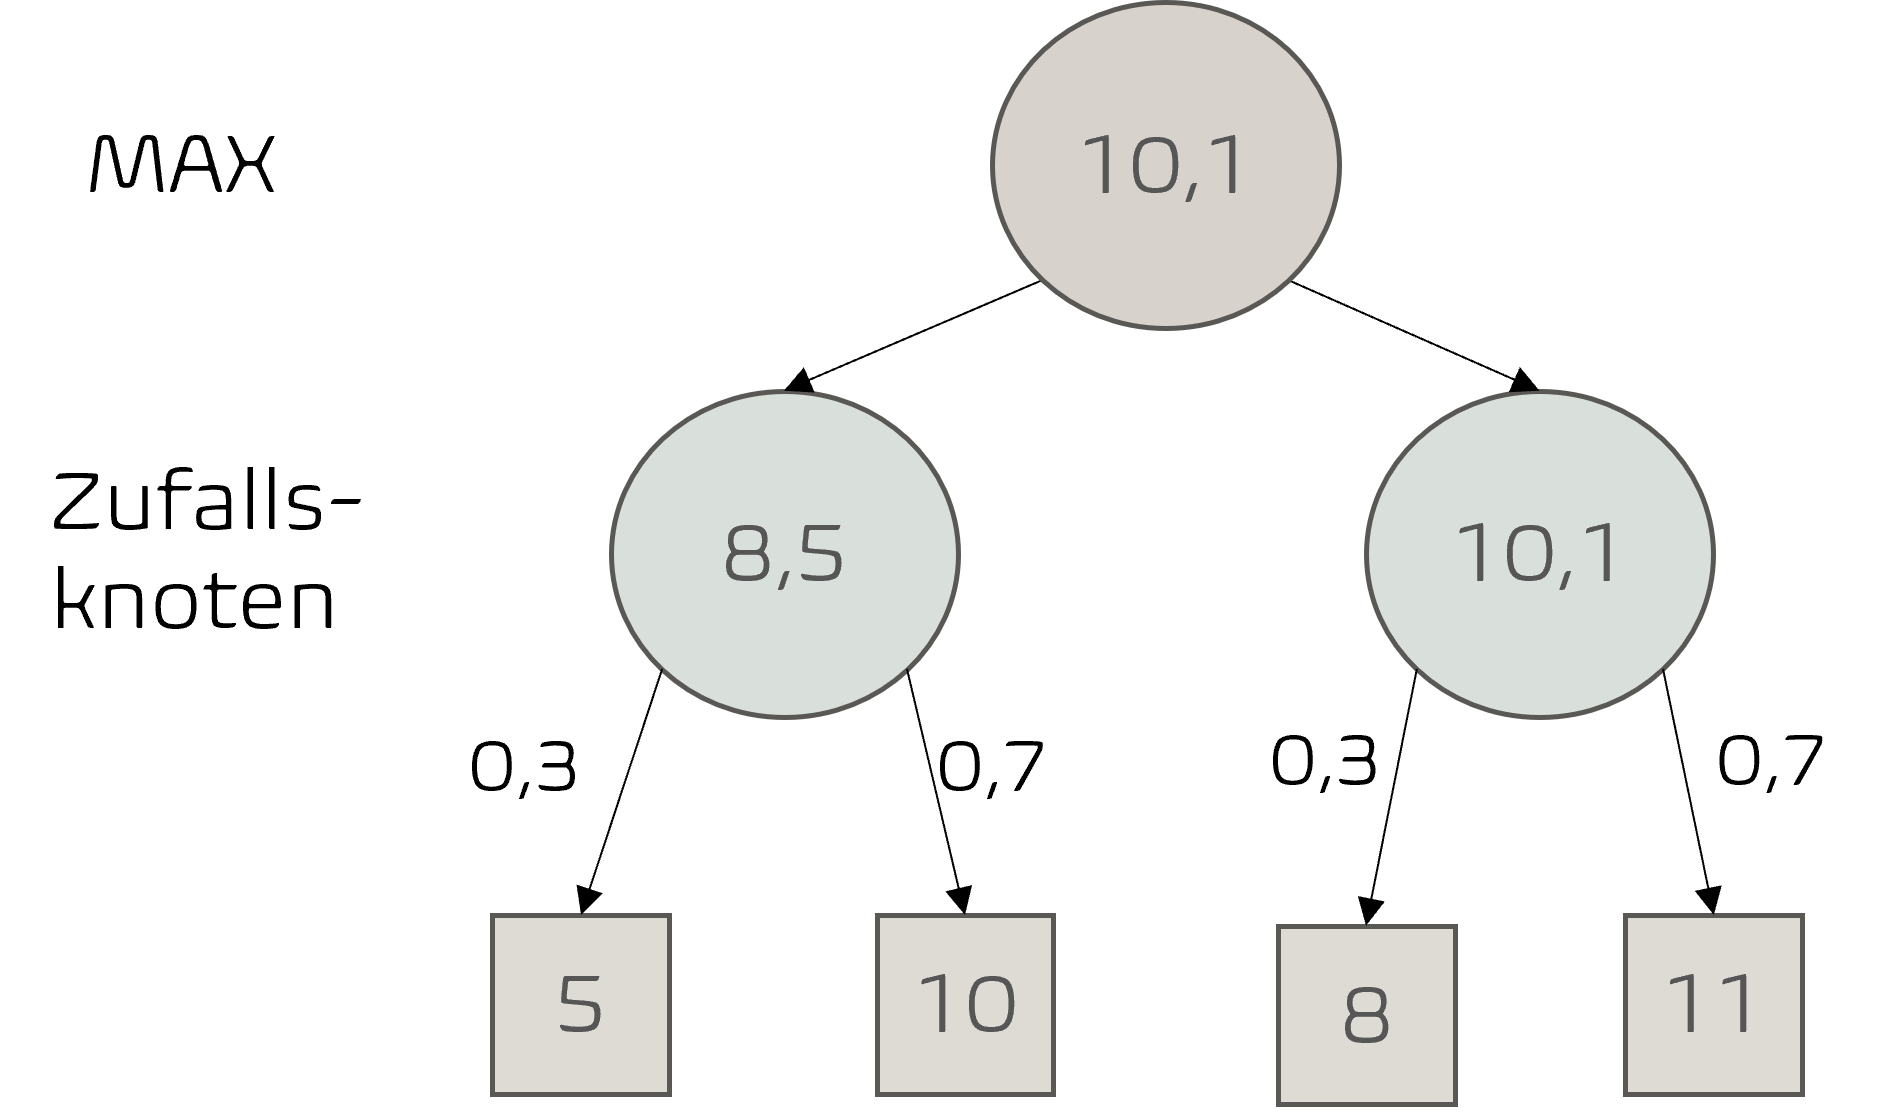
eigene Aufnahme CC BY 4.0
Algorithmus[5]
(nach [5:1], ursprünglich von Donald Michie vorgeschlagen [6])
Ein möglicher Psydocode:
WENN Ast ist ein Bewertungsast ODER Tiefe = 0
        return die heuristische Bewertung der aktuellen Situation
    WENN der Gegner am Zug ist
        // Gib den mit dem geringsten Wert bewerteten Zug zurück
        let α := +∞
        FÜR JEDEN Zug des Astes
            α := min(α, expectiminimax(Nachfolger, Tiefe-1))
    SONST WENN wir am Zug sind
        // Gib den mit dem höchsten Wert bewerteten Zug zurück
        let α := -∞
        FÜR JEDEN Zug des Astes
            α := max(α, expectiminimax(Nachfolger, Tiefe-1))
    SONST WENN zufälliges Ereignis
        // Gib durchschnittliche Bewertung aller Möglichkeiten zurück
        let α := 0
        FÜR JEDEN Nachfolger des Astes
            α := α + (Wahrscheinlichkeit[Nachfolger] * expectiminimax(Nachfolger, Tiefe-1))
    return α
Anwendungsbereiche
Der Expectimax Algorithmus wird vor allem in der Spieltheorie und in der Entwicklung von Computerspiel KI eingesetzt, wenn Spiele nicht nur aus gegnerischen Entscheidungen, sondern auch aus zufälligen Ereignissen bestehen. Typische Beispiele sind Spiele wie Backgammon, bei denen Würfelwürfe den Spielverlauf maßgeblich beeinflussen, oder klassische Würfel und Kartenspiele, in denen die Reihenfolge gezogener Karten oder die Wahrscheinlichkeit bestimmter Ereignisse berücksichtigt werden müssen.
Vorteile
Expectimax kann im Gegensatz zu MiniMax auch Zufallsereignisse modellieren und liefert daher optimale Entscheidungen in stochastischen Spielumgebungen.
Nachteile
- Wenn Zustände mit +∞oder -∞bewertet werden, führt dies zu Informationsverlust, da der Erwartungswert ebenfalls unendlich wird.
- Expectimax ist aufgrund der zusätzlichen Zufallsknoten rechenintensiver als MiniMax.
Pruning
Genau wie bei der Alpha Beta Suche ist es auch im Expectimax Algorithmus möglich, Pruning einzusetzen, um den Suchbaum zu verkleinern und die Laufzeit deutlich zu reduzieren.
Pruning: ist das gezielte Wegschneiden von Ästen, deren weitere Betrachtung keinen Einfluss mehr auf das endgültige Ergebnis hat.
Dabei wird bei jedem MAX Knoten geprüft, ob die verbleibenden Nachfolger den aktuellen Wert überhaupt noch verbessern können. Ist dies nicht der Fall, werden die entsprechenden Teilbäume nicht weiter untersucht.
*-Minimax-Algorithmus
Einleitung
Expectimax kann Zufallsknoten nicht mit klassischem Alpha Beta pruning beschneiden, da Zufallsknoten keine Max/Min Entscheidungen treffen. Die *-Minimax Algorithmen lösen dieses Problem, indem sie Schranken für Erwartungswerte berechnen.[7] Durch diese Schranken lässt sich bereits während der Berechnung abschätzen, ob ein Zufallsknoten noch innerhalb des relevanten Alpha Beta Fensters liegen kann. Liegt der geschätzte Erwartungswert sicher außerhalb dieses Fensters, kann der entsprechende Teilbaum frühzeitig verworfen werden.
Auf diese Weise reduzieren die *-Minimax Algorithmen die Größe des Suchbaums erheblich und ermöglichen es, auch weit verzweigte und stochastische Spielbäume effizient zu durchsuchen.
Grundidee
Die Grundidee der *-Minimax Algorithmen besteht darin, Pruning auch im Expectimax Verfahren zu ermöglichen. Da Zufallsknoten keine Max /Min Entscheidungen treffen, kann klassisches Alpha Beta Pruning dort nicht direkt angewendet werden. Die -Minimax Algorithmen umgehen dieses Problem, indem sie Schranken für den Erwartungswert eines Zufallsknotens berechnen – auch dann, wenn noch nicht alle Nachfolger untersucht wurden.
Dazu werden für unbesuchte Kindknoten theoretische Extremwerte festgelegt.
Einen besipielhaften Psydocode für das Spiel Carcassonne ist hier zu finden.
Theoretische Extremwerte:
- L = Theoretischer Minimalwert: gibt den möglichen Minimalwert für einen noch nicht unterscuhten Kindknoten an, meistens bei MAX-Knoten verwendet
- U = Theoretischer Maximalwert: gibt den möglichen Maximalwert für einen noch nicht untersuchten Kindknoten an, meistens bei MIN-Knoten verwendet
Mit diesen Werten lässt sich bereits während der Suche ein unterer bzw. oberer Erwartungswert abschätzen. Liegt dieser geschätzte Erwartungswert sicher außerhalb des Alpha Beta Fensters, kann der entsprechende Teilbaum vorzeitig abgeschnitten werden, ohne dass alle Nachfolger vollständig untersucht werden müssen.
Alpha-beta Fenster:
- Gibt an, welcher Wertebereich für den aktuellen Knoten noch relevant ist
- Liegt der geschätzte Werte sicher außerhalb des Fensters, so kann der Teilbaum abgeschnitten werden
Auf diese Weise ermöglichen die *-Minimax Algorithmen effizientes Pruning in stochastischen Spielbäumen und reduzieren die Anzahl der zu untersuchenden Knoten erheblich.
Anwendungsbereiche
Diese Abwandlung wird vor allem in Spielen eingesetzt, die sowohl stochastische Elemente als auch einen großen Zustandsraum besitzen – etwa Backgammon, Carcassonne oder verschiedene Würfel und Kartenspiele. Durch das Pruning der *-Minimax Algorithmen können solche Spiele auch bei begrenzter Rechenzeit effizient untersucht werden. Dadurch lässt sich selbst in komplexen, zufallsbehafteten Spielsituationen der optimale Zug bestimmen, was insbesondere für KI Agenten von zentraler Bedeutung ist.
Star1[7:1][8]
Star1 ist die einfachste Variante der *-Minimax Algorithmen und führt erstmals Pruning an Zufallsknoten ein. Die zentrale Idee besteht darin, das Alpha Beta Fenster des übergeordneten MAX oder MIN Knotens zu nutzen, um abzuschätzen, ob der erwartete Wert eines Zufallsknotens überhaupt noch relevant sein kann.
Ein Zufallsknoten besitzt mehrere mögliche Nachfolger, die jeweils mit ihrer Wahrscheinlichkeit gewichtet werden. Während Expectimax alle Nachfolger vollständig durchsuchen muss, versucht Star1, den erwarteten Wert bereits während der Berechnung einzugrenzen. Dadurch kann der Algorithmus frühzeitig erkennen, ob ein Zufallsknoten den relevanten Wertebereich verlassen wird – und in diesem Fall den restlichen Teilbaum nicht weiter untersuchen.
Grundprinzip:
Star1 erweitert Expectimax um Alpha Beta Pruning, angewendet auf Zufallsknoten.[8:1] Nach jedem bereits untersuchten Kindknoten wird eine Schätzung des Erwartungswerts des Zufallsknotens berechnet. Liegt dieser geschätzte Wert außerhalb des Alpha Beta Fensters, können die verbleibenden Nachfolger sofort verworfen werden, da sie das Ergebnis nicht mehr beeinflussen können.
Die Besonderheit von Star1 besteht darin, dass dieses Pruning bereits möglich ist, bevor alle Kindknoten untersucht wurden. Für die noch nicht betrachteten Nachfolger werden sogenannte theoretische Extremwerte eingesetzt:
L = theoretischer Minimalwert der Bewertungsfunktion
U = theoretischer Maximalwert der Bewertungsfunktion
Diese Werte ersetzen die unbekannten Nachfolger und erlauben es, eine untere bzw. obere Schranke für den gesamten Erwartungswert zu berechnen. Liegt diese Schranke sicher außerhalb des Alpha Beta Fensters, wird ein Cut off ausgelöst.
Ein Cut off tritt also genau dann auf, wenn bewiesen werden kann, dass der endgültige Expectimax Wert nicht mehr innerhalb des Suchfensters liegen kann.
Cut-off-Bedingungen:[8:2]
1. Gleichverteilte Wahrscheinlichkeiten
Wenn alle Nachfolger dieselbe Wahrscheinlichkeit besitzen, tritt ein Cut off ein, sobald eine der folgenden Bedingungen erfüllt ist:
Obere Schranke (mit U):
\frac{(V_1+\dots+V_{i}) + U\cdot (N-i)}{N} \le \alpha
Untere Schranke (mit L):
\frac{(V_1+\dots+V_{i}) + L\cdot (N-i)}{N} \ge \beta
Dabei gilt:
N = Gesamtzahl der Nachfolger
V_i = Wert des i-ten Nachfolgers
2. Unterschiedliche Wahrscheinlichkeiten
Wenn die Nachfolger mit unterschiedlichen Wahrscheinlichkeiten eintreten, lauten die Cut off Bedingungen:
Obere Schranke (mit U):
(P_1 V_1 + \dots + P_{i-1} V_{i-1}) + P_i V_i + U \cdot (1 - P_1 - \dots - P_i) \le \alpha
Untere Schranke (mit L):
(P_1 V_1 + \dots + P_{i-1} V_{i-1}) + P_i V_i + L \cdot (1 - P_1 - \dots - P_i) \ge \beta
Dabei gilt:
N = Gesamtzahl der Nachfolger
V_i = Wert des i ten Nachfolgers
P_i = Wahrscheinlichkeit des i ten Nachfolgers
Diese Formeln berücksichtigen, dass in vielen Spielen die Wahrscheinlichkeiten der Ereignisse nicht gleichverteilt sind.
Dieses Vorgehen zeigt auch, warum die Reihenfolge der Nachfolger wichtig ist: Wenn die wahrscheinlichsten Ereignisse zuerst untersucht werden, werden die Schranken schneller präzise, und Pruning wird wahrscheinlicher.
Beispiel:
Ein Zufallsknoten besitzt drei mögliche Nachfolger. Zwei davon wurden bereits vollständig bewertet, der dritte noch nicht. Handelt es sich beim dritten Nachfolger um einen MAX Knoten, erhält er als vorläufigen Wert den theoretischen Minimalwert L, da MAX im schlechtesten Fall den geringstmöglichen Wert wählen könnte.
Setzt man die bekannten Werte und Wahrscheinlichkeiten in die Erwartungswertformel ein, ergibt sich eine untere Schranke.
- Liegt diese bereits über β, wird der Teilbaum abgeschnitten, da der endgültige Wert sicher zu hoch wäre.
- Liegt sie unter α, gilt das Gleiche in die andere Richtung.
Für die obere Schranke wird analog der theoretische Maximalwert U eingesetzt. Auch hier gilt: Wenn die Schranke das Alpha Beta Fenster sicher verlässt, erfolgt ein Cut off.
Eigenschaften:
- Korrektheit: Star1 liefert stets denselben Wert wie der vollständige Expectimax Algorithmus.
- Pruning: In vielen Fällen müssen deutlich weniger Knoten untersucht werden, da Star1 frühzeitig abschätzen kann, ob ein Zufallsknoten das Alpha Beta Fenster verlassen wird.
- Wenn keine Schranken greifen, findet kein Pruning statt. In diesem Fall entspricht die Komplexität exakt der von Expectimax.
- Star1 setzt für alle noch unbesuchten Nachfolger extreme Ersatzwerte (L oder U) ein. Dadurch entstehen oft sehr grobe Schranken, was bedeutet:
Die Abschätzungen sind häufig ungenau.
Viele Nachfolger müssen dennoch vollständig untersucht werden.
Das Pruning fällt insgesamt schwächer aus als bei Star2 oder Star2.5.
Star2[7:2][8:3]
Star2 ist eine Weiterentwicklung von Star1 und nutzt zusätzlich eine Sondierungsphase (Probing Phase), um frühzeitig genauere Schranken für die Nachfolger eines Zufallsknotens zu erhalten. Der Algorithmus setzt voraus, dass der zugrunde liegende Baum ein regulärer Expectimax Baum ist.
Grundprinzip:
Star2 erweitert Star1 um eine Sondierungsphase (Probing Phase), die vor der eigentlichen Suche ausgeführt wird. In dieser Phase wird nicht jeder Nachfolger vollständig untersucht, sondern für jeden möglichen Zufallsnachfolger nur das erste Kind betrachtet. Da die Star Algorithmen auf Negamax basieren, handelt es sich bei diesen Kindern immer um MAX Knoten, die mit Negamax bewertet werden.
Negamax-Algorithmus:
Dieser Algorithmus wandelt potentielle MIN-Knoten in MAX-Knoten um. Dafür nutzt er folgende Identität:\min(x) = -\max(-x)Damit kann man jeden MIN Knoten ersetzen durch:
einen MAX Knoten
der den negierten Wert seiner Kinder maximiert
Der Wert dieses ersten Kindes dient anschließend als untere Schranke für den jeweiligen Nachfolger. Dadurch erhält jeder Nachfolger des Zufallsknotens eine individuelle, realistischere Schranke, anstelle des globalen theoretischen Minimalwerts L, den Star1 für alle unbesuchten Nachfolger verwendet.
Aus diesen individuellen Schranken wird fortlaufend eine Abschätzung des Erwartungswerts des Zufallsknotens berechnet. Liegt dieser geschätzte Wert bereits außerhalb des Alpha Beta Fensters, kann ein Cut off durchgeführt werden: Alle noch nicht untersuchten Nachfolger werden verworfen, da sie das Ergebnis nicht mehr beeinflussen können.
Führt die Sondierungsphase nicht zu einem Cut off (insbesondere wenn der Beta Wert nicht überschritten wird), müssen anschließend alle Nachfolger vollständig durchsucht werden. Das Suchfenster ist jedoch nun enger, da die in der Probing Phase gewonnenen Werte als verbesserte untere Schranken dienen. Jeder Nachfolger besitzt damit eine eigene, präzisere Schranke anstelle des theoretischen Minimalwerts.
In der anschließenden Suchphase wird der Star1 Algorithmus ausgeführt – jedoch nicht mehr mit dem globalen Wert L, sondern mit den individuellen Schranken aus der Sondierungsphase. Dadurch wird das Pruning in dieser zweiten Phase deutlich effektiver.
Merkmale:
- Verbesserte untere Schranken: Die in der Sondierungsphase ermittelten Werte ersetzen den theoretischen Minimalwert L. Dadurch entstehen deutlich präzisere Schranken in der anschließenden Suchphase.
- Effizienteres Pruning: Durch die genaueren Schranken kann Star2 wesentlich häufiger Teilbäume verwerfen als Star1.
- Starke Abhängigkeit vom Move Ordering: Die Reihenfolge, in der die Nachfolger sondiert werden, beeinflusst die Effektivität des Algorithmus erheblich.
- Liefern die ersten sondierten Kinder große oder extreme Werte, wird das Alpha Beta Fenster schneller verlassen. Dadurch steigt die Wahrscheinlichkeit eines frühen Cut offs deutlich.
- Ein gutes Move Ordering ist daher entscheidend für die Leistungsfähigkeit von Star2.
Star2.5[7:3][8:4]
Star2.5 ist eine Weiterentwicklung von Star2. In der Probing Phase wird pro Nachfolger nicht nur ein einziges Kind untersucht, sondern mehrere. Die genaue Anzahl dieser Kinder wird durch den sogenannten Probing Faktor festgelegt. Ein Probing Faktor von 0 entspricht Star1, da dort keine Sondierungsphase existiert. Ein Probing Faktor von 1 entspricht Star2. Erst ab einem Wert größer als 1 spricht man von Star2.5.
Dabei gibt es zwei Varianten, um mehr als ein Kind zu untersuchen:[8:5]
Cyclic Star2.5:
Beim zyklischen Star2.5 werden die Kinder eines Nachfolgers einzeln nacheinander sondiert, es werden demzufolge ggf. mehrere Sondierungsphasen durchgeführt. Nach jedem untersuchten Kind wird der Erwartungswert des Zufallsknotens aktualisiert und überprüft, ob dieser bereits außerhalb des Alpha Beta Fensters liegt. Tritt ein Cut off auf, wird die Sondierung sofort beendet. Erfolgt kein Cut off, wird das nächste Kind betrachtet. Dieser Prozess wird fortgesetzt, bis entweder ein Cut off eintritt oder der Probing Faktor ausgeschöpft ist.
Sequential Star2.5:
Das sequentielle Star2.5, führt dagegen nur eine einzige Sondierungsphase pro Nachfolger aus. Dabei wird direkt die festgelegte Anzahl an Kindern untersucht, die dem Probing Faktor entspricht. Erst nach Abschluss dieser einmaligen Sondierung wird geprüft, ob ein Cut off möglich ist. Da diese Methode nur eine einzige Sondierungsrunde benötigt, verursacht sie deutlich weniger Overhead.
Wenn während der Sondierungsphase kein Cut off stattfindet, wird der höchste der gefundenen Werte als untere Schranke für den jeweiligen Nachfolger verwendet. Mit diesen präziseren Schranken wird anschließend der Star1 Algorithmus ausgeführt, wodurch das Pruning in der Suchphase deutlich effektiver wird.
Merkmale:
- Star2.5 erzeugt deutlich präzisere untere Schranken, was die Wahrscheinlichkeit für Cut offs wesentlich erhöht.
- Der Algorithmus ist flexibler als Star2, da der Probing Faktor frei gewählt und damit an die verfügbare Rechenzeit angepasst werden kann.
- Durch die zusätzlichen sondierten Kinder erhält der Algorithmus wesentlich bessere Informationen über den Suchraum, sodass Cut offs nicht nur häufiger, sondern auch früher auftreten.
Vergleich
| Algorithmus | Idee | Vorteile | Nachteile | Typische Anwendung |
|---|---|---|---|---|
| Star1 | Pessimistische, vorher festgelegte Schranken | einfach, sicher | wenig Pruning | kleine Bäume |
| Star2 | Schranken in Probing‑Phase festgelegt | Viel Pruning möglich, da pro Nachfolger ein Kind untersucht wird | abhängig vom Move Ordering | mittlere Bäume |
| Star2.5 | Schranken in Probing‑Phase festgelegt, mehrere Kinder untersucht | Bestes Pruning durch präzisere Schranken | teuer | große Bäume |
Referenzen
Bildquellen
Abbildung 1: eigene Aufnahme
Literaturverzeichnis
https://de.wikipedia.org/wiki/Minimax-Algorithmus (letzter Zugriff 06.01.2026 um 12:13 Uhr) ↩︎
https://www.hsbi.de/elearning/data/FH-Bielefeld/lm_data/lm_1358898/games/games2-minimax.html (letzter Zugriff 06.01.2026 um 23:06 Uhr) ↩︎ ↩︎ ↩︎
RODGERS, Philip; LEVINE, John. An investigation into 2048 AI strategies. In: 2014 IEEE Conference on Computational Intelligence and Games. IEEE, 2014. S. 1-2.
pdf ↩︎https://doc.neuro.tu-berlin.de/bachelor/2024-BA-MohammedMaqsood.pdf ↩︎
https://de.wikipedia.org/wiki/Expectiminimax-Algorithmus#cite_note-1 (letzter Zugriff 06.01.2026 um 16:44 Uhr) ↩︎ ↩︎
D. Michie: Game-playing and game-learning automata. In: Leslie Fox (Hrsg.): Advances in Programming and Non-Numerical Computation. Pergamon Press, Oxford u. a. 1966, S. 183–200. ↩︎
BALLARD, Bruce W. The*-minimax search procedure for trees containing chance nodes. Artificial Intelligence, 1983, 21. Jg., Nr. 3, S. 327-350.
pdf ↩︎ ↩︎ ↩︎ ↩︎HEYDEN, Cathleen. Implementing a computer player for Carcassonne. Master's thesis, Department of Knowledge Engineering, Maastricht University, 2009. pdf ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎