2048
Der folgende Artikel orientiert sich besonders an [Zaky, 2014] und [Kao et al, 2022]
Allgemeines
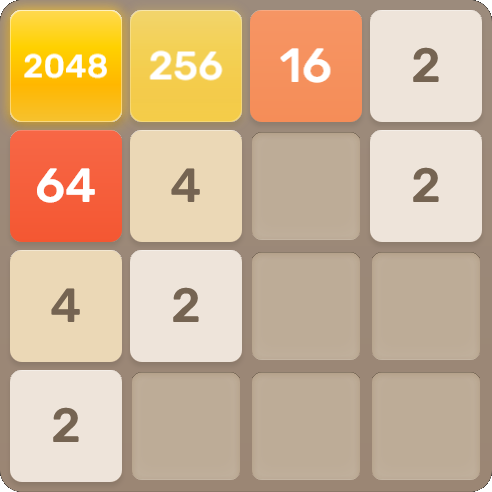
Das Spiel "2048" wurde am 9. März 2014 von Gabriele Cirulli einem italienischen Web-Entwickler unter der MIT-Lizenz veröffentlicht (GitHub) und ist ein Ableger des Spiels 1024, welches wiederum auf dem Spiel Saming´s 2048 basiert.[1][2][3][4] Außerdem gibt Cirulli zu, er habe sich indirekt vom Spiel Threes inspirieren lassen.[4:1] Alle genannten Spiele basieren auf dem Prinzip, Kacheln mit Zahlenwerten darauf zu kombinieren und somit höhere Werte zu erzeugen. Dabei variiert der Zahlenbereich von Spiel zu Spiel, sowie die Bedingungen unter denen die Kombination von Kacheln möglich sind.
Regeln
"2048" besteht standardmäßig aus einem 4x4-Kästchenfeld, wobei es noch weitere Varianten des Spiels mit z.B. größeren Feldern (6x6, 8x8,...) gibt. Das Ziel des Spiels ist es die Zahl "
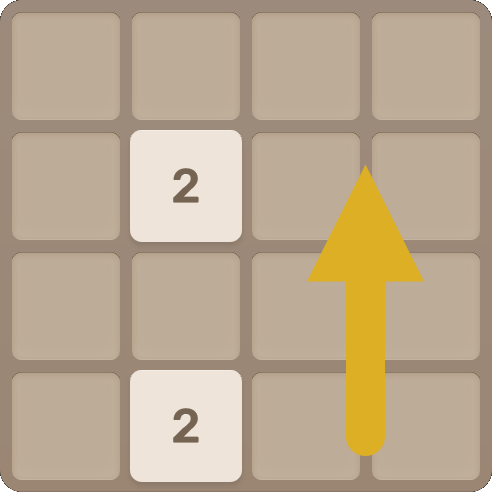
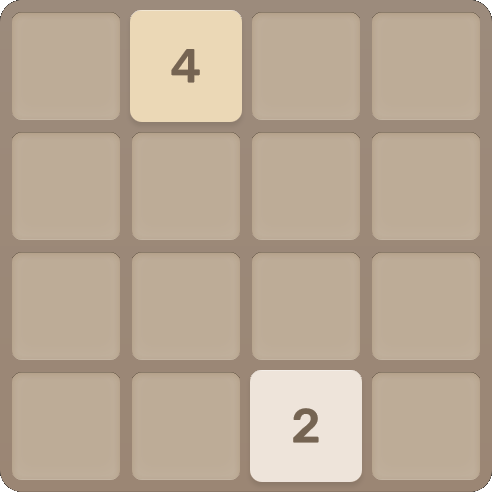
Hierbei befinden sich zu Beginn des Spiels zufälligerweise 2 Kacheln mit jeweils dem Wert "
Insgesamt gilt das Spiel als beendet wenn alle Felder belegt und keine Verschmelzungen von Kacheln mehr möglich sind.
Punktesystem
Im Spiel ist ein Punktesystem implementiert. Jede Kachel, die mit einer anderen verschmilzt, erhöht den zu Beginn auf Null gesetzten Punktestand um ihren Wert (
\sum_{i=2}^{n}{((n-1)\cdot 2^{n}-4)}
ohne Berücksichtigung der Auftrittswahrscheinlichkeiten [Details]
Formelbestandteile
n Zahl der Zweierpotenz ( 2^n ) des Kachelwerts welcher erzeugt werden soll-4 Wegen Generierung einer 4er-Kachel durch das Spiel, welche bei der Punkteberechnung nicht ins Gewicht fällt
berechnen und beträgt somit:
16\cdot(2^{17})-4+15\cdot(2^{16})-4+\dots+2\cdot(2^{3})-4+1\cdot(2^{2})-4\\
= 3.932.100 \text{ Punkte}
wenn vom Worst-Case-Szenario ausgegangen wird und immer nur eine $2$er-Kachel zufällig auf dem Feld generiert wird.[6] Wenn allerdings die Auftrittswahrscheinlichkeiten (von
\sum_{i=2}^{n}{((n-1) \cdot 2^{n}-\frac{2}{11}\cdot 4 \cdot 2^{n-2}-4)}=\sum_{i=2}^{n}{((n-\frac{13}{11})\cdot 2^{n}-4)}
unter Berücksichtigung der Auftrittswahrscheinlichkeiten [Details]
Formelbestandteile
n Zahl der Zweierpotenz ( 2^n ) des Kachelwerts welcher erzeugt werden soll-4 Wegen Generierung einer 4er-Kachel durch das Spiel, welche bei der Punkteberechnung nicht ins Gewicht fällt \frac{2}{11}{\cdot 4} Wegen der Wahrscheinlichkeitsverteilung bei der Generierung von 2 er- und4 er-Kacheln (aus 20 Generierungen sind im Durchschnitt 182 en und 24 en, woraus insgesamt9+2=11 4 en kombiniert werden können, von denen allerdings 2 nicht in die Punkteberechnung einfließen, da sie vom Spiel generiert wurden)
und somit:
(17-\frac{13}{11})\cdot(2^{17})-4+
(16-\frac{13}{11})\cdot(2^{16})-4+\dots\\
+(3-\frac{13}{11})\cdot(2^{3})-4+
(2-\frac{13}{11})\cdot(2^{2})-4\\
= 3.884.438,1818 \text{ Punkte}
als theoretisch höchste erreichbare Punktzahl.[6:1]
Vorgehen
Es gibt unterschiedliche Strategien und Lösungsansätze dieses Spielproblem zu lösen. Eine wäre zu versuchen die Kachel mit dem größten Wert in einer Ecke des Spielfelds zu behalten und die Zeile bzw. Spalte dann mit den nächstgrößeren zu füllen. Dies ist meist auch der erste Ansatz, wenn eine Person dazu aufgefordert wird die höchstmögliche Punktzahl zu erspielen / zu gewinnen.
Im folgenden wird allerdings darauf eingegangen, wie das Spielproblem mit algorithmischen Lösungsansätzen gelöst werden kann. Beispielsweise mit Hilfe von Minimax mit Alpha-Beta-Pruning, Expectimax (welcher darauf basiert)[5:1] oder auch mittels GumbelMuZero in Kombination mit StochasticMuZero (welche beide im Kern auf dem MonteCarloTreeSearch-Algorithmus basieren).[7]
Algorithmische Lösungsansätze
Minimax
      function minimax(node, depth, turn)
        if depth = 0 or node is a terminal node
          return the heuristic value of node
        if turn == player1
          bestValue := -∞
          for each child of node
            val := minimax(child, depth - 1, player2)
            bestValue := max(bestValue, val);
          return bestValue
        else
          bestValue := +∞
          for each child of node
            val := minimax(child, depth - 1, player1)
            bestValue := min(bestValue, val);
          return bestValue

      (* Initial call *)
      minimax(root, depth, player1)
C. 1 - Pseudocode für Minimax-Algorithmus Details
Die Funktionsweise vom Minimax-Algorithmus wird in folgendem Artikel genau erklärt. Daher wird nachfolgend nicht genauer auf die eigentliche Funktionsweise eingegangen (im Codeblock 1 der Pseudocode zur Erinnerung), sondern auf die Anwendung des Algorithmus zur Lösung des Spielproblems.
Minimax „betrachtet“ das Spiel so, als ob 2 Spieler es spielen würden[8], wobei der 1. Spieler versucht den höchstmöglichen Kachelwert zu erzeugen, indem er die Kacheln in eine der 4 Richtungen bewegt und der 2. „Spieler“ (der Computer) zufällig entweder eine 2er- oder eine 4er-Kachel pro Zug platziert (mit
Allerdings wurde im zugrundeliegenden Paper nicht erwähnt, welche Bewertungsfunktion für die nachfolgenden Simulationen verwendet wurde und ebenso nicht, wie groß der Performancezuwachs bei der Nutzung von Minimax mit Alpha-Beta Pruning im Vergleich zum „reinen“ Minimax-Algorithmus ist. Daher zeigt die nachfolgende Tabelle 1 den Performanceunterschied bei einer Anwendung der beiden Algorithmen auf ein Schachspiel, wo der Verzweigungsgrad noch bedeutend höher ist, als beim 2048 Spiel (16 Felder zu 64 Feldern).
Algorithmus |
Positionsbewertungen [ |
Anteil der Cutoffs [ |
Rechenzeit [ |
Minimax |
|||
Minimax + Alpha-Beta Pruning |
Minimax muss zur Bewertung einer Schachstellung fast 14 mal mehr Positionen und damit Knoten überprüfen, als die modifizierte Variante mit Alpha-Beta Pruning. Dies schlägt sich auch in einer fast 14-fach längeren Laufzeit nieder.
Aufgrund der sehr hohen Laufzeit bei der (hier beispielhaft gewählten) Berechnung einer Schachstellung, wird im folgenden auf eine Betrachtung der Lösung des Spielproblems mittels des „reinen“ Minimax-Algorithmus verzichtet, da dessen Einsatz hierbei nicht praktikabel ist.
Minimax mit Alpha-Beta Pruning
      function alphabeta(node, depth, α, β, turn)
        if depth = 0 or node is a terminal node
          return the heuristic value of node
        if turn == player1
          for each child of node
            α := max(α, alphabeta(child, depth - 1, α, β, player2))
            if β ≤ α
              break (* β cut-off *)
          return α
        else
          for each child of node
            β := min(β, alphabeta(child, depth - 1, α, β, player1))
            if β ≤ α
              break (* α cut-off *)
          return β

      (* Initial call *)
      Alphabeta(root, depth, -∞, +∞, player1)
C. 2 - Pseudocode für Minimax-Algorithmus mit Alpha-Beta Pruning Details
Die Funktionsweise vom Minimax-Algorithmus mit Alpha-Beta Pruning wird in folgendem Artikel erläutert. Daher gehe ich nicht genauer auf die eigentliche Funktionsweise ein (im Codeblock 2 daher nur der Pseudocode zur Erinnerung), sondern auf die Anwendung des Algorithmus zur Lösung des Spielproblems.
Der Algorithmus wird quasi genauso wie der „reine“ Minimax-Algorithmus auf das Spielproblem angewendet (siehe Abbildung 4). Er kann genauso tiefen limitiert verwendet werden und betrachtet das Spiel auch als "Zwei-Personen-Nullsummenspiel mit perfekter Information"[9].[10] Der größte Unterschied zeigt sich in der Laufzeit. Je nach Sortierung der Züge, ergibt sich eine signifikante Verringerung der Laufzeit, der Suchtiefe und damit auch der Anzahl der durchlaufenen Knoten (oder im Worst-Case maximal eine identische).[8:1] Dies wurde bereits weiter oben ersichtlich (Tabelle 1), nun aber nochmals anschaulicher in der nachfolgenden Abbildung. Bei dieser wird der am weitesten rechts stehende Teil des Baumes gar nicht erst exploriert, sondern direkt abgeschnitten (aufgrund des Alpha-Beta Prunings).
Der nachfolgende Expectimax-Algorithmus wurde jedoch nicht auf Grundlage des Minimax mit Alpha-Beta Pruning implementiert, sondern auf dem „reinen“ Minimax-Algorithmus aufgebaut (siehe Codeblock 2).[5:4]
Expectimax
      function expectimax(node, depth, turn)
        if depth = 0 or node is a terminal node
          return the heuristic value of node
        if turn == player1
          bestValue := -∞
          for each child of node
            val:= expectimax(child, depth-1, player2)
            bestValue := max(bestValue, val);
          return bestValue
        else
          expectedValue := 0
          for each child of node
            val:= expectimax(child, depth-1, player1)
            expectedValue += Probability[child]*val;
          return expectedValue

      (* Initial call *)
      expectimax(root, depth, player1)
C. 3 - Pseudocode für Expectimax-Algorithmus Details
Expectimax basiert auf dem Minimax-Algorithmus und funktioniert dementsprechend ähnlich (siehe Codeblock 3). Im Unterschied zu Minimax, wo der Zug mit dem größtmöglichen Gewinn gewählt wird (siehe Codeblock 2), werden bei Expectimax allerdings alle möglichen Züge berechnet, gewichtet mit ihrer jeweiligen Auftrittswahrscheinlichkeit und derjenige ausgewählt, welcher am vielversprechendsten erscheint. Dafür wird eine Heuristik/heuristische Funktion verwendet, welche mittels einer gegebenen Spielstellung alle / einen Teil der möglichen Spielzüge anhand vorher spezifizierter Kriterien bewertet. Die im folgenden vorgestellte Heuristik basiert im wesentlichen auf 3 Beobachtungen (veranschaulicht in Abbildung 5):
- Empty Spaces - Es gibt leere Felder
→ im folgendenE genannt- Je mehr leere Felder es auf dem Spielfeld gibt, desto besser und einfacher lassen sich Kacheln kombinieren.
- Smoothness - Um eine Kachel mit einem höheren Wert zu erzeugen, müssen zwei nebeneinanderliegende Kacheln desselben Wertes miteinander kombiniert werden (ohne Hindernis dazwischen)
→ im folgendenD genannt
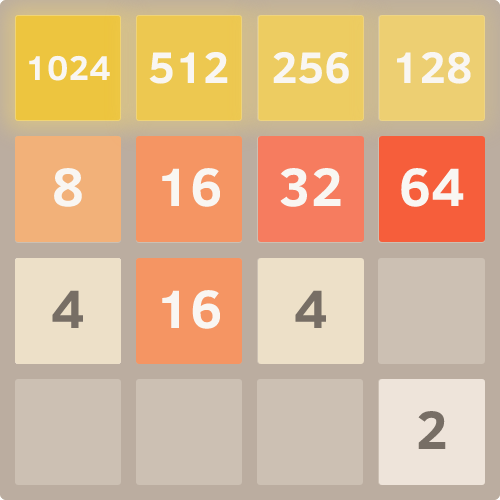
- Big Tiles in Border - (folgt z.T. aus 2.) Die Anordnung der Kacheln entlang der Ränder (wobei die Kachel mit dem aktuell größten Wert in einer Ecke gehalten wird)
→ entspricht im folgendenP=Feldgrenzendistanz\cdot Kachelwert - Es kann in jedem Zug keine größere Kachel als die aktuell größte geben.
- Die Wahrscheinlichkeit, dass eine Verschmelzung mit der Kachel mit dem aktuell höchsten Wert in diesem Zug stattfindet, ist am geringsten. Daher ist es sinnvoll, dass sie die geringste Anzahl an Berührungspunkten mit anderen Kacheln hat. Das trifft nur auf die Eckposition(en) zu.
Die daraus abgeleitete heuristische Funktion sieht folgendermaßen aus:
H=A\cdot E-B\cdot D-C\cdot P
Formelbestandteile:
A ,B ,C Konstanten zur Gewichtung (wobei der Faktor A beliebig gewählt werden kann solange er deutlich größer als die übrigen Werte ist) E Repräsentiert die leeren Felder (die standardmäßig einen hohen Wert zugewiesen bekommen) D Beschreibt die Unterschiedlichkeit benachbarter Felder (Differenz nebeneinanderliegender Felder) P Steht für die Distanz zur nächstgelegenen Feldgrenze multipliziert mit dem Kachelwert
Wenn man die Gewichtungsfaktoren mit den Werten
Algorithmus |
Geschwindigkeit [ |
Tiefenlimit |
Gewinnchance [ |
Minimax + Alpha-Beta Pruning |
|||
Expectimax |
|||
Minimax + Alpha-Beta Pruning |
|||
Expectimax |
Wie in der Tabelle 2 ersichtlich, hat die Wahl des Tiefenlimits einen sehr großen Einfluss, sowohl auf die Gewinnchance, als auch auf die Geschwindigkeit der Berechnungen. Bei einem halb so hohen Tiefenlimit von
Der Suchbaum wächst nahezu exponentiell mit jeder weiter hinzukommenden Ebene. Für jeden möglichen Zug muss unter der Berücksichtigung der Auftrittswahrscheinlichkeit der 2er- bzw. 4er-Kacheln von jedem leeren Feld mittels der Heuristik berechnet werden, wie gewinnbringend der aktuelle/gewählte Zug im Durchschnitt höchstwahrscheinlich ist. Dies gilt im Grunde genommen sowohl für den Expectimax-, als auch den Minimax-Algorithmus mit Alpha-Beta Pruning. Dadurch, dass beim Minimax mit Alpha-Beta Pruning Pfade im Suchbaum abgeschnitten und damit nicht exploriert werden, ist der Algorithmus objektiv betrachtet zwar performanter, aber dafür quasi im selben Maße ungenauer (was die Zugbewertung angeht), als Expectimax. Dieser nutzt eine recht komplexe Heuristikfunktion zur Bewertung, arbeitet dafür aber (in der genutzten Implementation) ohne Pruning.
Daran kann man erkennen, dass Expectimax im Vergleich zu Minimax mit Alpha-Beta Pruning, deutlich besser performt was die Zugbewertung und damit die Gewinnchancen angeht. Dies ist der Fall, obwohl ein deutlich geringeres Tiefenlimit verwendet werden muss (aufgrund der Verwendung einer Heuristikfunktion) und trotz der damit einhergehenden Geschwindigkeitseinbußen.
Abschnitt "Expectimax" stark an [5:5] orientiert
Weitere Heuristiken
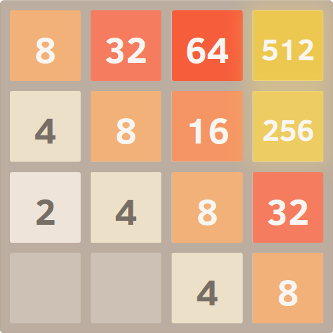
Es gibt auch Ansätze mit anderen Heuristiken:
- Ebenfalls in JavaScript geschrieben gibt es einen, der eine Gewinnchance von
90\% ermöglicht. Die Heuristik besteht hierbei auch aus der Betrachtung der leeren Felder und dem Minimieren der Wertunterschiede zwischen den Kacheln. Hinzu kommt die Betrachtung der Monotonie (in Abbildung 6 veranschaulicht). In jeder Zeile und Spalte sollen die Kacheln ihrem Wert nach auf- bzw. absteigend sortiert sein. - Ein weiterer Ansatz – in C++ geschrieben – ermöglicht sogar eine Gewinnchance von
100\% und erzeugte in13 von100 Fällen eine16384 er-Kachel auf dem Spielfeld. Die Heuristik ist dabei deutlich simpler und besteht nur daraus, die leeren Felder zu betrachten und der Kachel mit dem höchsten Wert einen hohen Wert innerhalb der Heuristik zuzuweisen, wenn sie sich in einer Ecke befindet.
Abschnitt "Weitere Heuristiken" stark an [5:6] orientiert
GumbelMuZero in Kombination mit StochasticMuZero
GumbelMuZero und StochasticMuZero basieren im Kern auf dem Monte-Carlo-Tree-Search-Algorithmus.[7:1] Aus Monte-Carlo-Tree-Search, in Verbindung mit Deep-Neural-Networks, wurde der AlphaGo-Algorithmus entwickelt, welcher speziell für das Spiel Go geschrieben wurde.[11] Während bei AlphaGo außer den Spielregeln noch Datenbanken und Simulationen in Kombination mit überwachtem Lernen und bestärkendem Lernen im voraus als input dienten, ist dies bei AlphaGoZero bis auf die Spielregeln nicht mehr nötig.[11:1] Dabei bedeutet überwachtes Lernen, dass normalerweise ein Mensch die Daten vorher klassifiziert hat[12] und bestärkendes Lernen, dass der Algorithmus durch Erfahrungen (try and error) lernt und versucht, die bei Erfolg erhaltenen Belohnungen zu maximieren.[13] AlphaGoZero trainiert sich quasi selbst, ohne menschliche Spieldaten.[11:2] AlphaZero ist im Endeffekt die verallgemeinerte Version von AlphaGoZero. Der Algorithmus lässt sich außer auf das Spiel Go noch auf viele weitere Spiele anwenden, wie beispielsweise Schach oder Shogi und spielt dabei besser als jeder Mensch.[11:3]
MuZero ist ein Nachfolger von AlphaZero und verzichtet ebenfalls auf menschliche Trainingsdaten, aber zusätzlich noch auf die Vorgabe von Regeln.[14] Der Algorithmus lernt diese selbstständig und ohne menschliches Eingreifen, mithilfe von neuronalen Netzen.[7:2] MuZero ist allerdings nicht in der Lage mit stochastischen Ereignissen effektiv umzugehen, denn der Algorithmus basiert auf einem deterministischen Modell.[7:3] Aus diesem Grund wurde der StochasticMuZero-Algorithmus entwickelt. Dieser ist ist in der Lage, stochastische Modelle zu erlernen und in der zugrundeliegenden Baumsuche zu berücksichtigen.[7:4] GumbelMuZero löst unter anderem ein weiteres Problem des MuZero-Algorithmus, denn dieser skaliert mit wenigen Simulationen recht schlecht.[7:5]
flowchart LR;
    A("MonteCarloTreeSearch<br>+<br>DeepNeuralNetworks"):::begin--=-->B(AlphaGo);
    B:::mid-->C(AlphaGoZero);
    C:::mid--"⁂"-->D(AlphaZero)
    D:::mid-->E(MuZero);
    E:::mid-->F(StochasticMuZero);
    E-->G(GumbelMuZero);
    style A fill:red,stroke:#333,stroke-width:4px,font-weight:bold
    style F fill:lightgreen,stroke:#333,stroke-width:4px,font-weight:bold
    style G fill:lightgreen,stroke:#333,stroke-width:4px,font-weight:bold
    classDef mid fill:white,stroke:#333,stroke-width:4px,font-weight:normal
FC. 1 - Übersicht über Entwicklungshierarchie des MuZero-Algorithmus
Anmerkungen
⁂ : "verallgemeinert zu" ➨ AlphaGoZero wurde zuerst entwickelt und dann zu AlphaZero verallgemeinert
GumbelMuZero alleine kann nicht effektiv mit stochastischen Modellen umgehen, wie es aber eigentlich für das Spiel "2048" vonnöten wäre. Umgekehrt skaliert StochasticMuZero schlecht mit einer geringen Anzahl an Simulationen (siehe Abbildung 7 links; der Punktestand liegt fast konstant bei $0$). Deshalb wurden diese beiden Algorithmen kombiniert in diesem Paper genutzt (GumbelMuZero wurde in StochasticMuZero integriert; im folgenden der Kürze halber StochasticGumbelMuZero genannt), um das Spielproblem für das Spiel "2048" in einer annehmbaren Zeit zu lösen. Nach nur 3 Simulationen und dem Training mit
Abschnitt stark an [6:2] und [7:6] orientiert
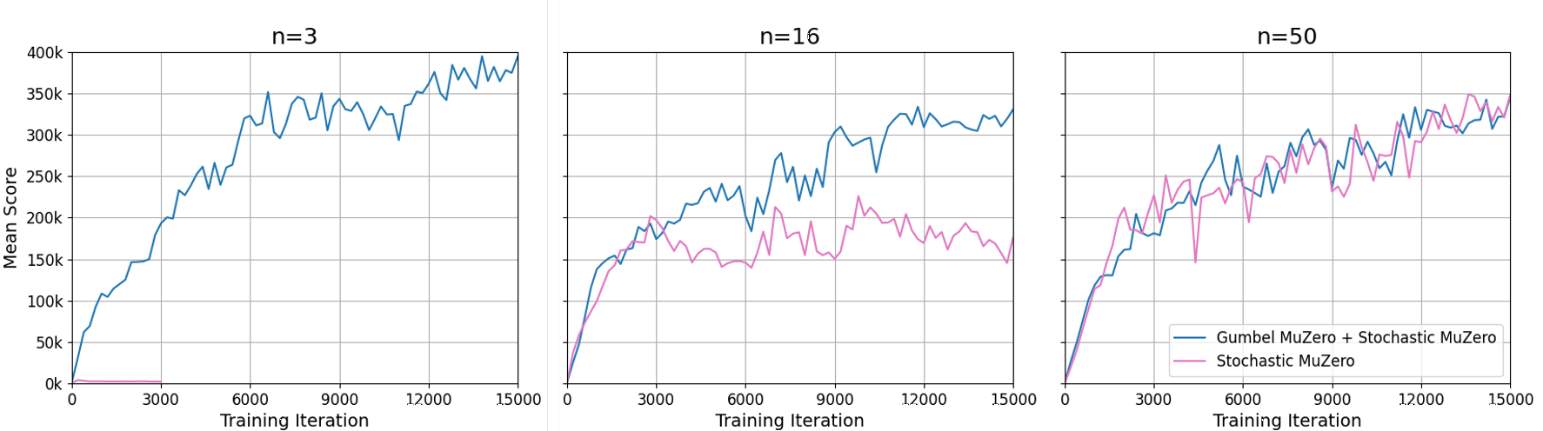
Insgesamt gilt, je geringer die Anzahl an Simulationen, die für jeden Spieldurchlauf genutzt werden, desto schlechter performt StochasticMuZero (siehe Abbildung 7).
Je nachdem wie viele Simulationen und Trainingsdurchläufe der jeweilige Algorithmus durchlaufen hat, ergeben sich dementsprechend unterschiedliche Punktzahlen, sowie Geschwindigkeiten. Wie in den 3 Graphen zu erkennen, steigt die Anzahl der Punkte bei gleichzeitig geringerer Anzahl an Trainingsdurchläufen schneller und höher an, je geringer die Anzahl an Simulationen ist (Abbildung 7 links, bei
In der nachfolgenden Tabelle 3 wird StochasticMuZero mit einer Geschwindigkeit von
Algorithmus |
Simulationen für Trainingsdurchläufe [ |
Geschwindigkeitszuwachs |
StochasticMuZero |
||
GumbelMuZero+StochasticMuZero |
||
Wie in der Tabelle 3 zu erkennen, steigt die Geschwindigkeit von StochasticGumbelMuZero bei Reduzierung der Simulationsanzahl - von Anfangs 1-facher, bis letztendlich mehr als 7-facher Geschwindigkeit - immer stärker an. Die Geschwindigkeit von StochasticMuZero bei Reduzierung der Simulationsanzahl ist dagegen nicht relevant, da die Punktanzahl (wie aus Abbildung 7 herauszulesen ist) mit sinkender Simulationsanzahl gegen
Insgesamt heißt das, dass StochasticGumbelMuZero nicht nur eine höhere Punktzahl als StochasticMuZero erreicht (im Worst-Case eine identische), sondern dies auch noch in kürzerer Zeit und mit weniger Speicherbedarf, aufgrund der geringeren Anzahl an Simulationen.
Zwei darüber liegende Abschnitte stark an [7:7] orientiert
Fazit
Alles in allem hängt es sehr stark vom verwendeten Algorithmus, dessen Implementation, aber auch von der verwendeten Programmiersprache ab, wie „gut“ das Spielproblem gelöst werden kann.
Je nachdem, welche Heuristik und welches Tiefenlimit beispielsweise beim Ansatz mit Minimax gewählt wird, können die Gewinnchancen zwischen einer
Beim Einsatz der verschiedenen Varianten von MuZero, beeinflusst dagegen die verwendete Anzahl an Simulationen, sowie die Anzahl an Trainingsdurchläufen, die Geschwindigkeit und im Endeffekt auch die Gewinnchancen. Je geringer die Anzahl an Simulationen, desto schneller ist der verwendete Algorithmus (StochasticGumbelMuZero) und erreicht bei nur 3 Simulationen - und
Welcher Algorithmus letztendlich (unter anderem auch für das Spiel "2048") verwendet werden sollte, ist zum einen Geschmackssache, zum anderen aber auch von den Gegebenheiten, unter denen er eingesetzt werden soll, abhängig. Ist es nötig mit stark begrenztem Speicherplatz umzugehen? Ist die Geschwindigkeit relevant oder wird auf Energieeffizienz Wert gelegt? Soll der Algorithmus speziell nur auf ein (Spiel-)Problem oder mehrere anwendbar sein?
Dies alles können Faktoren sein, die die Wahl beeinflussen, denn im Endeffekt können beide Ansätze Expectimax (zwar in anderer Programmiersprache und mit anderer Heuristikfunktion geschrieben) und StochasticGumbelMuZero durchschnittlich eine
Abschnitt "Fazit" besonders an [6:3], [5:7] und [7:8] orientiert, aber eigentlich insgesamt an allen aufgeführten Quellen
Offene Fragen / Ausblick
- Warum wurde Expectimax nicht in Verbindung mit AlphaBeta-Pruning verwendet, sondern mit dem „reinen“ Minimax-Algorithmus?
- Es wäre interessant, wie sich das Pruning in diesem besonderen Fall auf die Performance und damit auch auf die Gewinnchancen auswirken würde, da der momentan limitierende Faktor das Tiefenlimit ist und dieses damit angehoben werden könnte, ohne an Geschwindigkeit einzubüßen.
- Wie genau sieht die Bewertungsfunktion (in diesem Zusammenhang mitunter auch Heuristik/Heuristikfunktion genannt) bei den Versuchen mit dem „reinen“ Minimax-Algorithmus aus?
- Möglicherweise lässt sich durch eine geschicktere Wahl die Gewinnchance erhöhen, ohne etwas am restlichen Algorithmus zu verändern.
- Zusätzlich könnte sich die Performance verbessern, wenn eine ursprünglich komplexe Bewertungsfunktion vereinfacht werden kann.
- Wie sieht die Bewertungsfunktion (in diesem Zusammenhang mitunter auch Heuristik/Heuristikfunktion genannt) bei den Versuchen mit Minimax mit Alpha-Beta Pruning aus?
- Eventuell lässt sich hier ebenfalls durch eine geschicktere Wahl die Gewinnchance erhöhen.
- Es lässt sich eventuell genauso durch Vereinfachung ein Performancezuwachs verzeichnen.
- Wie hoch ist der Performancezuwachs von Minimax mit AlphaBeta-Pruning im Vergleich zum „reinen“ Minimax speziell auf das Spiel "2048" bezogen?
- Beziehen sich die weiteren Heuristiken die im Paper genannt werden auch auf den Expectimax-Algorithmus? (Dieser Wikiartikel geht davon aus)
- Wie ist die Geschwindigkeit von StochasticMuZero und StochasticGumbelMuZero im Vergleich zu den anderen Algorithmen (Minimax, Expectimax,...) einzuordnen (Züge/Sekunde)?
- Wie beeinflusst die Anzahl an Simulationen und verwendeten Trainingsdurchläufen die Geschwindigkeit von GumbelMuZero?
- Wie performen die Vorgänger von - und inklusive - dem „reinen“ MuZero-Algorithmus speziell auf das Spiel "2048" bezogen?
Referenzen / Verweise
Abbildungsverzeichnis
- Bild 1 - Beispiel eines gewonnenen 2048-Spiels - bearbeiteter Screenshot; Vorlage[15]
- Bild 2 - Beispiel eines Spielfelds vor Ausführung des ersten Zugs - bearbeiteter Screenshot; Vorlage[15:1]
- Bild 3 - Beispiel eines Spielfelds nach Ausführung des ersten Zugs - bearbeiteter Screenshot; Vorlage[15:2]
- Formel 1 - Berechnung der erhaltenen Punkte beim Erzeugen einer Kachel mit dem Wert $n$ ohne Berücksichtigung der Auftrittswahrscheinlichkeiten - Quelle[6:4]
- Formel 2 - Berechnung der erhaltenen Punkte beim Erzeugen einer Kachel mit dem Wert $n$ unter Berücksichtigung der Auftrittswahrscheinlichkeiten - (leicht modifiziert → Fehler in Formel mit darunter stehendem Kommentar behoben) Quelle[6:5]
- Codeblock 1 - Pseudocode für Minimax-Algorithmus - Quelle[5:8]
- Tabelle 1 - Beispielhafte Berechnung einer Schachstellung bei einer Suchtiefe von 4 - Quelle[10:1]
- Codeblock 2 - Pseudocode für Minimax-Algorithmus mit Alpha-Beta Pruning - Quelle[5:9]
- Bild 4 - Beispiel einer Zugbewertung durch Minimax mit Alpha-Beta Pruning tiefen limitiert auf 2 - selbst erstellt; Vorlage[8:2]
- Codeblock 3 - Pseudocode für Expectimax-Algorithmus - Quelle[5:10]
- Bild 5 - Beispiel eines erwünschten 2048-Spielfelds - Quelle[5:11]
- Tabelle 2 - Vergleich Minimax mit Alpha-Beta Pruning und Expectimax (mit A=4096, B=C=10) - Quelle[5:12]
- Bild 6 - Beispiel eines perfekt monotonen 2048-Spielfelds - Quelle[5:13]
- Flowchart 1 - Übersicht über Entwicklungshierarchie des MuZero-Algorithmus - selbst erstellt; Vorlage[7:9]
- Bild 7 - Einfluss von GumbelMuZero auf StochasticMuZero (mit n= Simulationen) - Quelle[7:10]
- Tabelle 3 - Geschwindigkeitsvergleich zwischen StochasticMuZero mit GumbelMuZero und StochasticMuZero bei Reduzierung der Simulationen für die Trainingsdurchläufe - Quelle[7:11]
Quellenverzeichnis
J. Schnorrenberg, „2048 – Ein Zeitfresser unter offener Lizenz“, netzpolitik.org. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://netzpolitik.org/2014/2048-ein-zeitfresser-unter-offener-lizenz/ ↩︎
2048 (Computerspiel)“, Wikipedia. 12. September 2024. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=2048_(Computerspiel)&oldid=248553041 ↩︎
2048 (video game)“, Wikipedia. 18. Dezember 2024. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://en.wikipedia.org/w/index.php?title=2048_(video_game)&oldid=1263829787 ↩︎
G. Cirulli, gabrielecirulli/2048. (2. Januar 2025). JavaScript. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://github.com/gabrielecirulli/2048 ↩︎ ↩︎
A. Zaky, „Minimax and Expectimax Algorithm to Solve 2048“, 15. Mai 2022, OSF. doi: 10.31219/osf.io/az7vf. Verfügbar unter: https://osf.io/az7vf ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Asusfood, „Highest possible score for 2048 (Warning: Math)“, r/2048. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://www.reddit.com/r/2048/comments/214njx/highest_possible_score_for_2048_warning_math/ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
C.-Y. Kao, H. Guei, T.-R. Wu, und I.-C. Wu, „Gumbel MuZero for the Game of 2048“, in 2022 International Conference on Technologies and Applications of Artificial Intelligence (TAAI), Dez. 2022, S. 42–47. doi: 10.1109/TAAI57707.2022.00017. Verfügbar unter: https://ieeexplore.ieee.org/abstract/document/10056566 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Sebastian Lague, Algorithms Explained – minimax and alpha-beta pruning, (20. April 2018). Zugegriffen: 7. Januar 2025. Online Video. Verfügbar unter: https://www.youtube.com/watch?v=l-hh51ncgDI ↩︎ ↩︎ ↩︎
„Minimax-Algorithmus“, Wikipedia. 10. August 2024. Zugegriffen: 22. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=Minimax-Algorithmus&oldid=247574240 ↩︎
„Alpha-Beta-Suche“, Wikipedia. 6. September 2023. Zugegriffen: 4. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=Alpha-Beta-Suche&oldid=237077282 ↩︎ ↩︎
„AlphaGo“, Wikipedia. 14. Januar 2025. Zugegriffen: 14. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=AlphaGo&oldid=252238638 ↩︎ ↩︎ ↩︎ ↩︎
„Überwachtes Lernen“, Wikipedia. 13. Januar 2025. Zugegriffen: 17. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=Überwachtes_Lernen&oldid=252210422 ↩︎
„Bestärkendes Lernen“, Wikipedia. 15. Januar 2025. Zugegriffen: 17. Januar 2025. Online. Verfügbar unter: https://de.wikipedia.org/w/index.php?title=Bestärkendes_Lernen&oldid=252284939 ↩︎
„MuZero“, Wikipedia. 6. Dezember 2024. Zugegriffen: 17. Januar 2025. Online. Verfügbar unter: https://en.wikipedia.org/w/index.php?title=MuZero&oldid=1261565955 ↩︎
G. Cirulli, „2048 by Gabriele Cirulli“, 2048. Zugegriffen: 2. Januar 2025. Online. Verfügbar unter: https://play2048.co/ ↩︎ ↩︎ ↩︎